


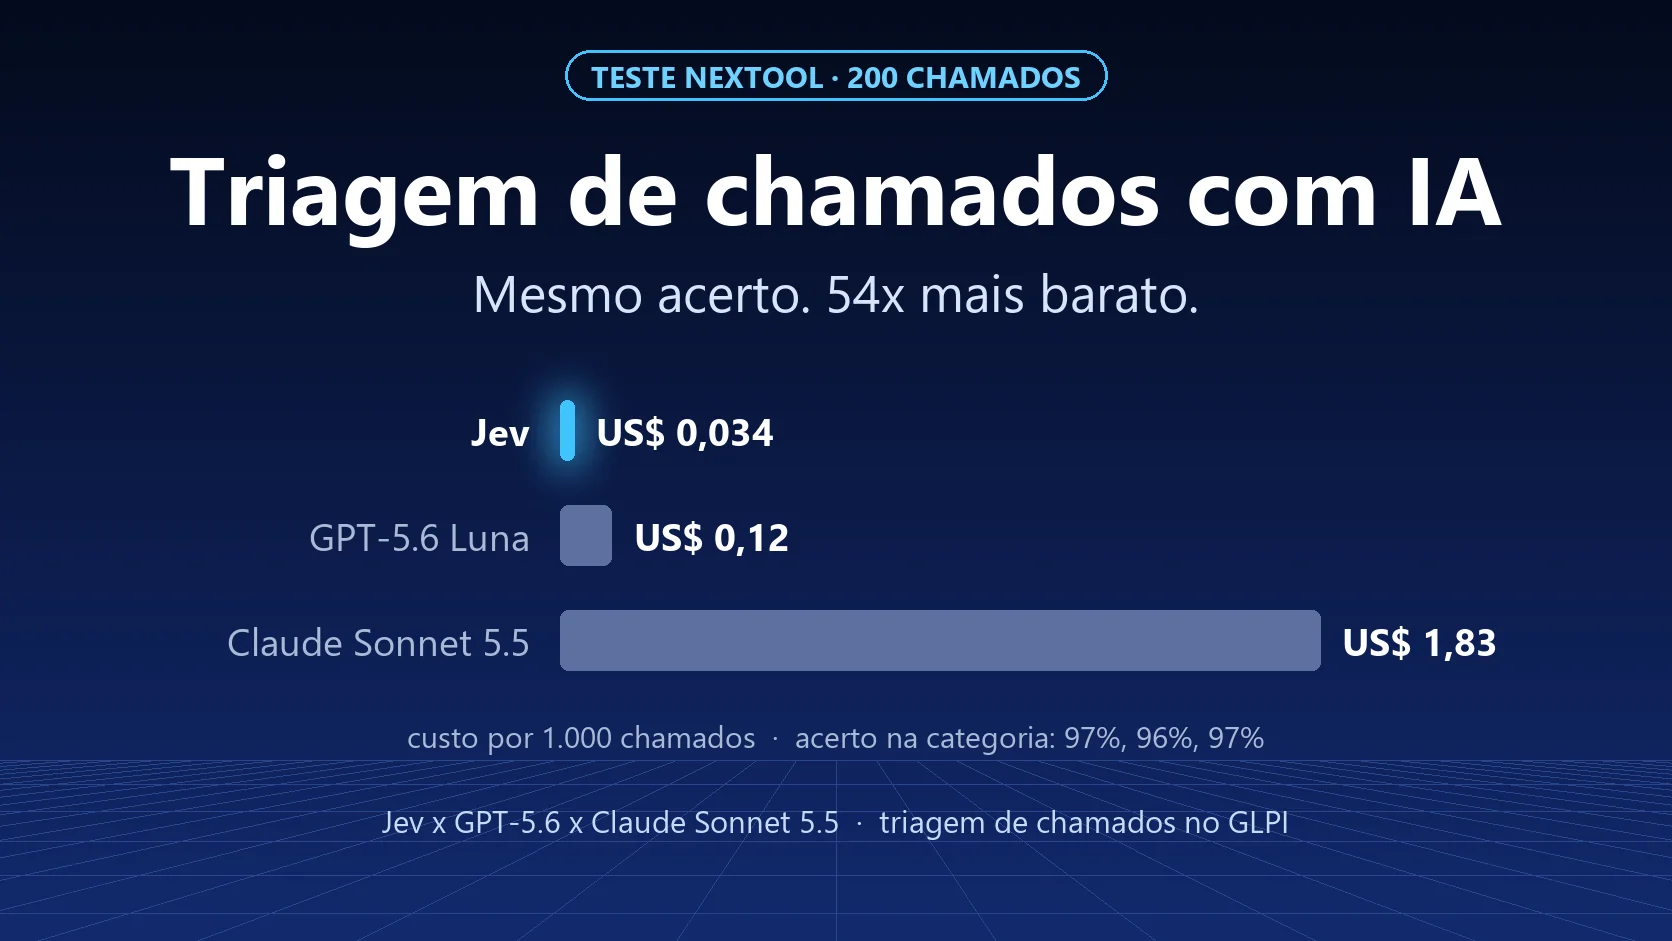
Classificar mil pedidos com IA custou 0,034 US$ com o Jev, 0,12 US$ com o GPT-5.6 Luna e 1,83 US$ com o Claude Sonnet 5.5. Os três acertaram a categoria em 96% a 97% das vezes. Fizemos o teste com 200 pedidos de um centro de serviços fictício para responder a uma pergunta que quase ninguém faz antes de pôr IA no suporte: para fazer a triagem de um pedido, precisa mesmo de um modelo que escreve?
O estrangulamento que ninguém mede: a triagem
Cada pedido passa por três decisões antes de alguém começar a resolvê-lo: qual a categoria, se é um incidente ou uma requisição, e qual a urgência. Quando a triagem falha, o pedido vai para a fila errada, espera, é reclassificado e o SLA começa a correr contra a equipa. Em muitas operações, a triagem ainda é manual, feita pelo primeiro nível entre um atendimento e outro.
É uma tarefa de decisão, não de escrita. Foi por isso que o lançamento do Jev nos chamou a atenção.
O que é o Jev e porque é diferente
O Jev foi lançado pela TypeSafe AI a 15 de setembro de 2026 e está disponível através do OpenRouter desde 18 de setembro. Não gera texto. Envia o contexto (o texto do pedido) e perguntas tipadas, e ele devolve:
- uma escolha entre opções definidas (por exemplo, a categoria);
- sim ou não, com a probabilidade (por exemplo, se é incidente);
- uma nota numa escala (por exemplo, a urgência).
Para cada resposta indica a confiança. E como não escreve, paga-se basicamente a entrada: 0,042 US$ por milhão de tokens, segundo o fabricante. Um LLM, mesmo quando só se pede um JSON curto, cobra entrada e saída e demora mais a responder.
Como montámos o teste
- 200 pedidos fictícios de uma empresa inventada, a Acme: 25 de cada categoria (rede, acessos, ERP, e-mail e Office, impressora, hardware, software, telefonia), escritos como os utilizadores escrevem de verdade, com pressa, abreviaturas e dois problemas no mesmo texto. Nenhum dado real.
- Respostas certas definidas antes do teste: a categoria, o tipo (incidente ou requisição) e a urgência (baixa, média, alta, crítica), com regras escritas para cada nível. Dezasseis pedidos são ambíguos de propósito, daqueles em que um técnico também hesitaria.
- As mesmas perguntas e definições para os três modelos, através do OpenRouter, com temperatura zero e fornecedores que não retêm dados: o Jev 1.13, o GPT-5.6 Luna (o modelo económico da OpenAI) e o Claude Sonnet 5.5 (um modelo de topo da Anthropic).
- Medimos acerto, tempo de resposta e custo de cada chamada. O teste completo custou cerca de 0,40 US$.
Os resultados
| Jev 1.13 | GPT-5.6 Luna | Claude Sonnet 5.5 | |
|---|---|---|---|
| Categoria certa | 97,0% | 96,0% | 97,0% |
| Incidente ou requisição | 97,0% | 98,0% | 98,0% |
| Urgência exata | 83,5% | 85,0% | 84,5% |
| Urgência com até 1 nível de diferença | 99,5% | 100% | 100% |
| As três respostas certas | 79,0% | 81,0% | 82,0% |
| Categoria nos 16 ambíguos | 93,8% | 87,5% | 87,5% |
| Tempo de resposta (mediana) | 0,66 s | 1,6 s | 2,1 s |
| Custo por 1.000 pedidos | 0,034 US$ | 0,12 US$ | 1,83 US$ |

No acerto, empate técnico: a diferença entre os três é de um ou dois pedidos em duzentos. No custo, o Jev ficou 54 vezes mais barato do que o Claude Sonnet 5.5 e quase 4 vezes mais barato do que o GPT-5.6 Luna. No tempo, respondeu 2,5 a 3 vezes mais depressa, e com pouca variação: 95% das respostas chegaram em menos de 0,75 s.
A TypeSafe anuncia um fluxo "444 vezes mais barato do que um LLM de topo". Não reproduzimos esse número, e não é estranho: a comparação dela usa outra tarefa e outro modelo. No nosso teste, a vantagem foi de 54 vezes face a um modelo de topo, o que já muda as contas de qualquer operação.
O que só o classificador entrega: a confiança
O dado mais útil do teste não está na tabela de acerto. É a confiança que o Jev devolve em cada resposta. Com ela, é possível decidir quando a IA faz a triagem sozinha e quando um técnico verifica:
| A IA decide sozinha quando a confiança é de pelo menos | Pedidos triados sozinhos | Acerto nesses pedidos | Vão para um técnico |
|---|---|---|---|
| 0,5 | 99,0% | 97,0% | 2 |
| 0,7 | 93,5% | 98,9% | 13 |
| 0,8 | 90,0% | 98,9% | 20 |
| 0,9 | 85,0% | 98,8% | 30 |
Com o corte em 0,7, 93,5% dos pedidos seriam triados sem intervenção, com 98,9% de acerto, e 13 em 200 iriam para a fila humana. Um exemplo do que esse corte apanha: o pedido "recebemos um e-mail a pedir a palavra-passe e dois colegas escreveram-na", um ataque de phishing, foi classificado como e-mail com confiança 0,68. Abaixo do corte, iria para um técnico, que é exatamente onde deve estar.
Os LLM também podem devolver uma "confiança" se lha pedirmos, mas é um texto que o modelo escreve, não uma probabilidade calculada. Para decidir a automatização, isso faz diferença.
Onde os três falharam
Os erros dizem mais do que os acertos:
- Três pedidos os três modelos falharam da mesma forma. "O meu utilizador aparece com o nome errado no Teams e no e-mail" (acessos ou e-mail?), "ativar o perfil de aprovador no ERP" (acessos ou ERP?) e "o sistema de RH não abre depois da atualização" (software ou ERP?). Nos três, a nossa própria definição de categorias admite duas leituras. A lição: a taxonomia pesa mais do que o modelo. Antes de escolher a IA, reveja as categorias.
- A urgência é o ponto fraco de todos, com cerca de 15% de erro, quase sempre por um nível. O Jev tendeu a subir a urgência de pedidos médios e classificou como "alta" duas situações críticas (falha geral da internet e ERP em baixo). O GPT-5.6 Luna tendeu a baixar médias para baixas. A urgência crítica, que afeta vários departamentos ou a faturação, precisa de uma regra de negócio, não só de IA.
- Nos ambíguos, o Jev foi melhor (93,8% contra 87,5% dos dois LLM).
O que isto muda para quem usa o GLPI
O GLPI já resolve boa parte da triagem com regras de negócio: palavra-chave no título, origem do pedido, formulário. O problema é o pedido que chega por e-mail, escrito como a pessoa conseguiu escrever. É aí que entra um classificador de baixo custo:
- Primeiro as regras. O que pode ser decidido por regra, decida por regra: é previsível e gratuito. No NexTool, o módulo Regras de Pedido categoriza e preenche o pedido sozinho, por regras.
- Um classificador para o resto, com o corte de confiança a decidir o que vai para um humano.
- Atribuição depois da categoria certa. Com a categoria definida, a Atribuição Inteligente distribui os pedidos pelos técnicos do grupo, por balanceamento de carga ou rotação. Veja como funciona a atribuição automática no GLPI.
- Um LLM onde é insubstituível: resumir o histórico, sugerir a resposta e transformar o pedido resolvido em artigo, que é o que o AI Assist faz (IA para resumir e responder a pedidos no GLPI).
Usar um LLM de topo para fazer a triagem de pedidos é como chamar o especialista para separar a correspondência: funciona, mas sai caro e demora.
Antes de pôr em produção
- Dados próprios: o nosso teste usou pedidos fictícios, em português, escritos por nós. Repita o teste com uma amostra dos seus pedidos (anonimizada) antes de confiar no número.
- Calibração: o corte de confiança certo depende da sua base. Comece de forma conservadora (0,8 ou 0,9) e baixe-o com o tempo.
- RGPD: o texto do pedido sai do seu ambiente. Escolha fornecedores que não retêm dados, retire os dados pessoais sempre que possível e registe-o na sua avaliação de impacto.
- Uma só execução: corremos cada modelo uma vez, sem ajustar o prompt nem os critérios de cada um.
Conclusão
Para a triagem de pedidos, o modelo mais caro não acertou mais. O que separou os três foi o custo, o tempo e a confiança calibrada, que permite automatizar com segurança. A pergunta certa antes de pôr IA no centro de serviços não é "qual o melhor modelo", mas "que tarefa estou a resolver". No próximo artigo, usamos estes números para responder a outra: quanto custa a IA por pedido.
Quer rever a triagem e a atribuição do seu GLPI? Fale com a equipa.
Teste realizado pela equipa NexTool Solutions a 1 de outubro de 2026, com 200 pedidos fictícios e preços do OpenRouter nessa data. Modelos: typesafe/jev-1.13, openai/gpt-5.6-luna e anthropic/claude-sonnet-5.5.



