Tausend Tickets mit KI zu klassifizieren kostete 0,034 US$ mit Jev, 0,12 US$ mit GPT-5.6 Luna und 1,83 US$ mit Claude Sonnet 5.5. Alle drei trafen die Kategorie in 96 % bis 97 % der Fälle. Wir haben den Test mit 200 Tickets eines fiktiven Service Desk durchgeführt, um eine Frage zu beantworten, die vor der Einführung von KI im Support kaum jemand stellt: Brauchen Sie für die Ticket-Triage wirklich ein Modell, das Texte schreibt?
Der Engpass, den niemand misst: die Triage
Jedes Ticket durchläuft drei Entscheidungen, bevor jemand mit der Lösung beginnt: Welche Kategorie ist es, handelt es sich um eine Störung oder eine Anfrage, und wie dringend ist es? Wenn die Triage danebenliegt, landet ein Ticket in der falschen Warteschlange, wartet, wird neu klassifiziert, und die SLA läuft gegen das Team. In vielen Betrieben erfolgt diese Triage noch manuell, durch den First Level zwischen zwei Anfragen.
Es ist eine Entscheidungsaufgabe, keine Schreibaufgabe. Genau deshalb hat die Veröffentlichung von Jev unsere Aufmerksamkeit geweckt.
Was Jev ist und warum es anders ist
Jev wurde am 15. September 2026 von TypeSafe AI veröffentlicht und ist seit dem 18. September über OpenRouter verfügbar. Es erzeugt keinen Text. Sie senden den Kontext (den Text des Tickets) und typisierte Fragen, und es liefert zurück:
- eine Auswahl zwischen definierten Optionen (zum Beispiel die Kategorie);
- Ja oder Nein, mit der Wahrscheinlichkeit (zum Beispiel, ob es eine Störung ist);
- eine Bewertung auf einer Skala (zum Beispiel die Dringlichkeit).
Zu jeder Antwort gibt es die Konfidenz an. Und weil es nicht schreibt, zahlen Sie im Wesentlichen für die Eingabe: 0,042 US$ pro Million Tokens, laut Hersteller. Ein LLM berechnet, selbst wenn Sie nur ein kurzes JSON verlangen, Eingabe und Ausgabe und braucht länger für die Antwort.
Wie wir den Test aufgebaut haben
- 200 fiktive Tickets eines erfundenen Unternehmens, Acme: 25 aus jeder Kategorie (Netzwerk, Zugang, ERP, E-Mail und Office, Drucker, Hardware, Software, Telefonie), so geschrieben, wie Benutzer wirklich schreiben, in Eile, mit Abkürzungen und zwei Problemen im selben Text. Keinerlei echte Daten.
- Vor dem Test festgelegte Musterlösung: Kategorie, Typ (Störung oder Anfrage) und Dringlichkeit (niedrig, mittel, hoch, kritisch), mit schriftlichen Regeln für jede Stufe. Sechzehn Tickets sind absichtlich mehrdeutig, solche, bei denen auch ein Analyst zögern würde.
- Dieselben Fragen und Definitionen für alle drei Modelle, über OpenRouter, mit Temperatur null und Anbietern ohne Datenspeicherung: Jev 1.13, GPT-5.6 Luna (das günstige Modell von OpenAI) und Claude Sonnet 5.5 (ein Spitzenmodell von Anthropic).
- Gemessen haben wir Trefferquote, Antwortzeit und Kosten jedes Aufrufs. Der gesamte Test kostete etwa 0,40 US$.
Die Ergebnisse
| Jev 1.13 | GPT-5.6 Luna | Claude Sonnet 5.5 | |
|---|---|---|---|
| Richtige Kategorie | 97,0 % | 96,0 % | 97,0 % |
| Störung oder Anfrage | 97,0 % | 98,0 % | 98,0 % |
| Dringlichkeit exakt | 83,5 % | 85,0 % | 84,5 % |
| Dringlichkeit mit höchstens 1 Stufe Abweichung | 99,5 % | 100 % | 100 % |
| Alle drei Antworten richtig | 79,0 % | 81,0 % | 82,0 % |
| Kategorie bei den 16 mehrdeutigen | 93,8 % | 87,5 % | 87,5 % |
| Antwortzeit (Median) | 0,66 s | 1,6 s | 2,1 s |
| Kosten pro 1.000 Tickets | 0,034 US$ | 0,12 US$ | 1,83 US$ |
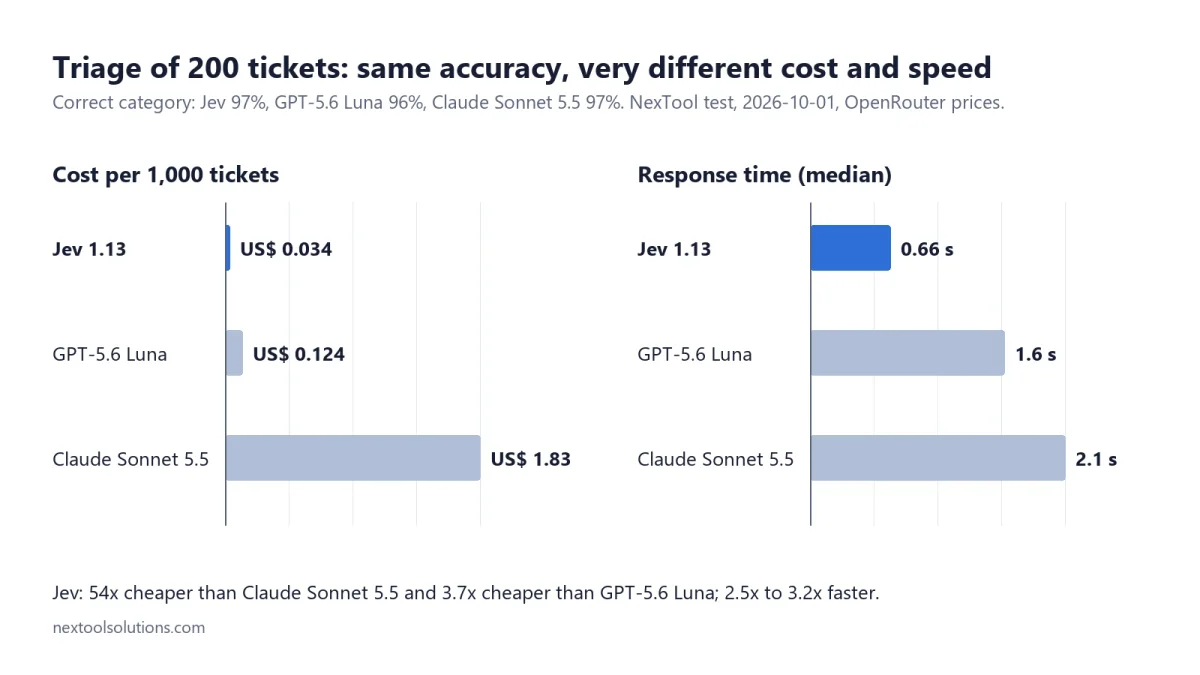
Bei der Trefferquote herrscht technischer Gleichstand: Der Unterschied zwischen den dreien beträgt ein oder zwei Tickets von zweihundert. Bei den Kosten war Jev 54-mal günstiger als Claude Sonnet 5.5 und fast 4-mal günstiger als GPT-5.6 Luna. Bei der Zeit antwortete es 2,5- bis 3-mal schneller, und mit geringer Schwankung: 95 % der Antworten kamen in weniger als 0,75 s.
TypeSafe wirbt mit einem Ablauf, der "444-mal günstiger als ein Spitzen-LLM" sei. Diese Zahl haben wir nicht reproduziert, und es ist nicht verwunderlich: Der Vergleich des Herstellers nutzt eine andere Aufgabe und ein anderes Modell. In unserem Test lag der Vorteil gegenüber einem Spitzenmodell beim 54-Fachen, was die Rechnung jedes Betriebs bereits verändert.
Was nur der Klassifikator liefert: die Konfidenz
Die nützlichste Information des Tests steht nicht in der Tabelle der Trefferquoten. Es ist die Konfidenz, die Jev zu jeder Antwort liefert. Mit ihr lässt sich entscheiden, wann die KI die Triage allein übernimmt und wann ein Analyst draufschaut:
| Die KI entscheidet allein bei einer Konfidenz von mindestens | Allein triagierte Tickets | Trefferquote bei diesen Tickets | Gehen an einen Analysten |
|---|---|---|---|
| 0,5 | 99,0 % | 97,0 % | 2 |
| 0,7 | 93,5 % | 98,9 % | 13 |
| 0,8 | 90,0 % | 98,9 % | 20 |
| 0,9 | 85,0 % | 98,8 % | 30 |
Mit der Schwelle bei 0,7 würden 93,5 % der Tickets ohne menschliches Zutun triagiert, mit 98,9 % Trefferquote, und 13 von 200 gingen in die menschliche Warteschlange. Ein Beispiel dafür, was diese Schwelle abfängt: Das Ticket "wir haben eine E-Mail bekommen, die nach dem Passwort fragt, und zwei Kollegen haben ihr Passwort eingegeben", ein Phishing-Angriff, wurde mit einer Konfidenz von 0,68 als E-Mail klassifiziert. Unterhalb der Schwelle würde es bei einem Analysten landen, genau dort, wo es hingehört.
Auch LLMs können eine "Konfidenz" zurückgeben, wenn Sie danach fragen, aber sie ist ein Text, den ein Modell schreibt, keine berechnete Wahrscheinlichkeit. Für die Entscheidung über Automatisierung macht dies einen Unterschied.
Wo alle drei danebenlagen
Die Fehler sagen mehr aus als die Treffer:
- Bei drei Tickets lagen alle drei Modelle auf dieselbe Weise falsch. "Mein Benutzer erscheint mit dem falschen Namen in Teams und in der E-Mail" (Zugang oder E-Mail?), "die Genehmigerrolle im ERP freischalten" (Zugang oder ERP?) und "das HR-System öffnet sich nach dem Update nicht" (Software oder ERP?). In allen drei Fällen lässt unsere eigene Definition der Kategorien zwei Lesarten zu. Die Lehre: Die Taxonomie wiegt schwerer als ein Modell. Bevor Sie eine KI auswählen, überarbeiten Sie die Kategorien.
- Die Dringlichkeit ist bei allen die Schwachstelle, mit rund 15 % Fehlern, fast immer um eine Stufe. Jev neigte dazu, die Dringlichkeit mittlerer Tickets anzuheben, und stufte zwei kritische Situationen (flächendeckender Internetausfall und ERP außer Betrieb) als "hoch" ein. GPT-5.6 Luna neigte dazu, mittlere auf niedrige herabzustufen. Kritische Dringlichkeit, die mehrere Bereiche oder die Fakturierung betrifft, braucht eine Geschäftsregel, nicht nur KI.
- Bei den mehrdeutigen Tickets war Jev besser (93,8 % gegenüber 87,5 % bei beiden LLMs).
Was sich für GLPI-Anwender ändert
GLPI erledigt einen großen Teil der Triage bereits mit Geschäftsregeln: Schlüsselwort im Titel, Herkunft des Tickets, Formular. Problematisch ist ein Ticket, welches per E-Mail ankommt, so geschrieben, wie die Person es eben geschafft hat. Genau hier setzt ein kostengünstiger Klassifikator an:
- Zuerst Regeln. Was sich per Regel entscheiden lässt, entscheiden Sie per Regel: vorhersehbar und kostenlos. Bei NexTool kategorisiert und befüllt Ticket Rules Tickets automatisch per Regeln.
- Klassifikator für den Rest, wobei die Konfidenzschwelle entscheidet, was an einen Menschen geht.
- Zuweisung nach der richtigen Kategorie. Steht die Kategorie fest, verteilt Smart Assign die Tickets auf die Techniker der Gruppe, per Lastausgleich oder Rotation. Lesen Sie, wie die automatische Zuweisung in GLPI funktioniert.
- LLM dort, wo es unersetzlich ist: den Verlauf zusammenfassen, Antworten vorschlagen und gelöste Tickets in Artikel verwandeln, genau dies leistet AI Assist (KI zum Zusammenfassen und Beantworten von Tickets in GLPI).
Ein Spitzen-LLM für die Ticket-Triage zu nutzen ist, als würde man einen Spezialisten rufen, um die Post zu sortieren: Es funktioniert, ist aber teuer und dauert.
Bevor Sie in Produktion gehen
- Eigene Daten: Unser Test nutzte fiktive, von uns auf Portugiesisch geschriebene Tickets. Führen Sie denselben Test mit einer (anonymisierten) Stichprobe Ihrer Tickets durch, bevor Sie sich auf die Zahl verlassen.
- Kalibrierung: Die richtige Konfidenzschwelle hängt von Ihrem Datenbestand ab. Beginnen Sie konservativ (0,8 oder 0,9) und senken Sie sie mit der Zeit.
- LGPD: Der Text des Tickets verlässt Ihre Umgebung. Wählen Sie Anbieter, die keine Daten speichern, entfernen Sie personenbezogene Daten, wo möglich, und dokumentieren Sie dies in Ihrer Datenschutz-Folgenabschätzung.
- Nur ein Durchlauf: Wir haben einen Lauf pro Modell durchgeführt, ohne Prompt oder Kriterien für jedes einzelne anzupassen.
Fazit
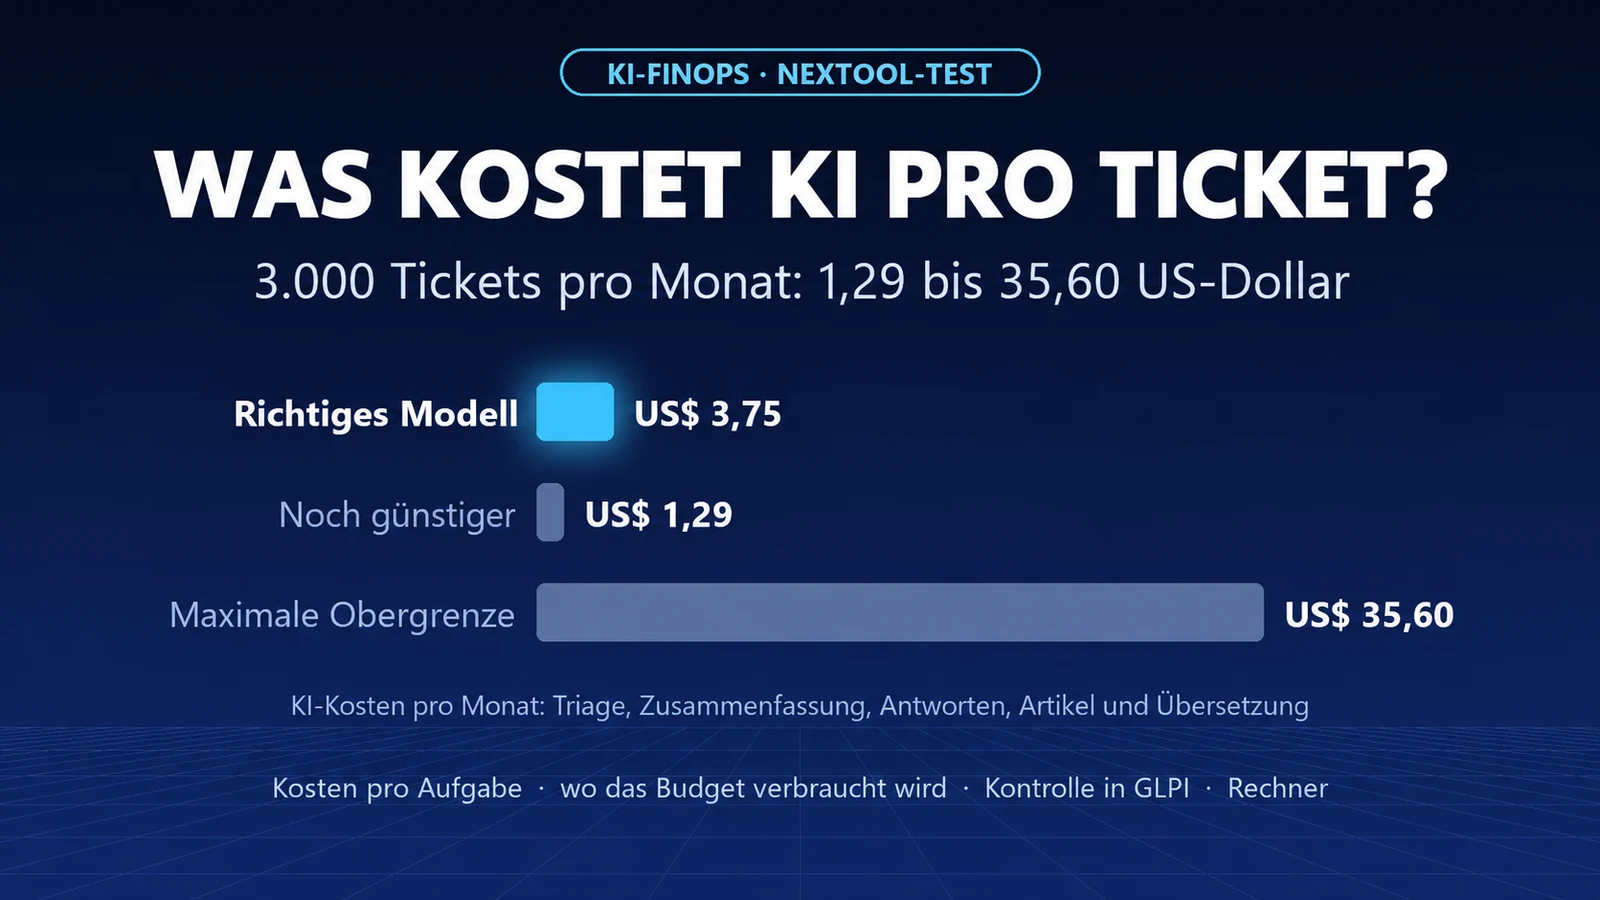
Bei der Ticket-Triage traf das teuerste Modell nicht häufiger. Was die drei unterschied, waren Kosten, Zeit und die kalibrierte Konfidenz, mit der sich sicher automatisieren lässt. Die richtige Frage vor dem Einsatz von KI im Service Desk lautet nicht "welches ist das beste Modell", sondern "welche Aufgabe löse ich". Im nächsten Artikel nutzen wir diese Zahlen, um eine andere Frage zu beantworten: Was kostet KI pro Ticket?
Möchten Sie Triage und Zuweisung in Ihrem GLPI überprüfen? Sprechen Sie mit unserem Team.
Test durchgeführt vom Team von NexTool Solutions am 1. Oktober 2026, mit 200 fiktiven Tickets und den an diesem Tag gültigen Preisen von OpenRouter. Modelle: typesafe/jev-1.13, openai/gpt-5.6-luna und anthropic/claude-sonnet-5.5.