Классификация тысячи заявок с помощью ИИ обошлась в US$ 0,034 с Jev, US$ 0,12 с GPT-5.6 Luna и US$ 1,83 с Claude Sonnet 5.5. Все три правильно определили категорию в 96–97% случаев. Мы провели тест на 200 заявках вымышленной службы поддержки, чтобы ответить на вопрос, который почти никто не задаёт, прежде чем внедрять ИИ в обслуживание: действительно ли для сортировки заявок нужна модель, которая пишет текст?
Узкое место, которое никто не измеряет: сортировка
Каждая заявка проходит через три решения, прежде чем кто-то начнёт её решать: какая категория, инцидент это или запрос, и какова срочность. Когда сортировка ошибается, заявка уходит не в ту очередь, ждёт, переклассифицируется, а SLA начинает работать против команды. Во многих организациях эта сортировка всё ещё ручная и выполняется первой линией между обращениями.
Это задача принятия решения, а не написания текста. Именно поэтому выход Jev привлёк наше внимание.
Что такое Jev и чем он отличается
Jev был выпущен компанией TypeSafe AI 15 сентября 2026 г. и доступен через OpenRouter с 18 сентября. Он не генерирует текст. Вы отправляете контекст (текст заявки) и типизированные вопросы, а он возвращает:
- выбор из заданных вариантов (например, категорию);
- да или нет с вероятностью (например, является ли это инцидентом);
- оценку по шкале (например, срочность).
Для каждого ответа он сообщает уверенность. А поскольку он не пишет, вы платите в основном за входные данные: US$ 0,042 за миллион токенов, по данным производителя. LLM, даже если попросить только короткий JSON, берёт плату за вход и выход и отвечает дольше.
Как мы построили тест
- 200 вымышленных заявок выдуманной компании Acme: по 25 на каждую категорию (сеть, доступ, ERP, почта и Office, принтер, оборудование, ПО, телефония), написанные так, как пишут настоящие пользователи — в спешке, с сокращениями и с двумя проблемами в одном тексте. Никаких реальных данных.
- Эталонные ответы определены до теста: категория, тип (инцидент или запрос) и срочность (низкая, средняя, высокая, критическая) с письменными правилами для каждого уровня. Шестнадцать заявок намеренно неоднозначны — такие, на которых засомневался бы и аналитик.
- Одинаковые вопросы и определения для всех трёх моделей через OpenRouter, с нулевой температурой и провайдерами без хранения данных: Jev 1.13, GPT-5.6 Luna (бюджетная модель OpenAI) и Claude Sonnet 5.5 (передовая модель Anthropic).
- Мы измеряли точность, время ответа и стоимость каждого вызова. Весь тест обошёлся примерно в US$ 0,40.
Результаты
| Jev 1.13 | GPT-5.6 Luna | Claude Sonnet 5.5 | |
|---|---|---|---|
| Верная категория | 97,0% | 96,0% | 97,0% |
| Инцидент или запрос | 97,0% | 98,0% | 98,0% |
| Точная срочность | 83,5% | 85,0% | 84,5% |
| Срочность с отклонением не более 1 уровня | 99,5% | 100% | 100% |
| Все три ответа верны | 79,0% | 81,0% | 82,0% |
| Категория в 16 неоднозначных | 93,8% | 87,5% | 87,5% |
| Время ответа (медиана) | 0,66 с | 1,6 с | 2,1 с |
| Стоимость на 1 000 заявок | US$ 0,034 | US$ 0,12 | US$ 1,83 |
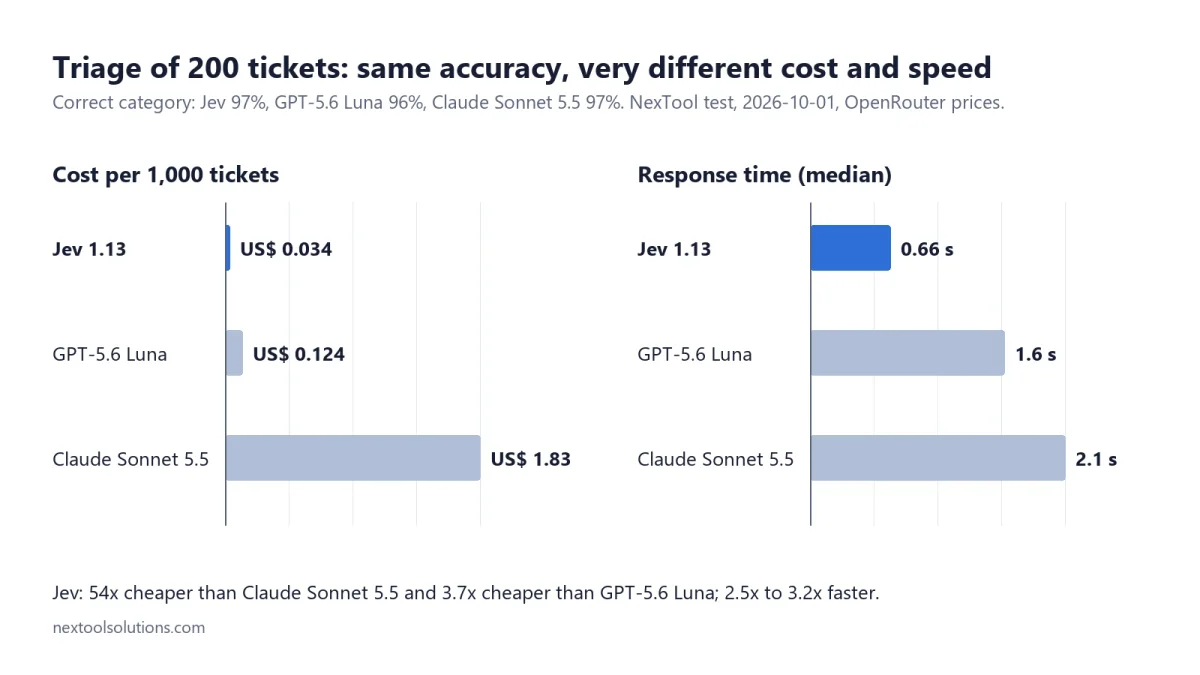
По точности — техническая ничья: разница между тремя моделями составляет одну-две заявки из двухсот. По стоимости Jev оказался в 54 раза дешевле Claude Sonnet 5.5 и почти в 4 раза дешевле GPT-5.6 Luna. По времени он отвечал в 2,5–3 раза быстрее и с небольшим разбросом: 95% ответов пришли менее чем за 0,75 с.
TypeSafe заявляет о сценарии, «в 444 раза более дешёвом, чем передовая LLM». Мы не воспроизвели эту цифру, и это неудивительно: в их сравнении другая задача и другая модель. В нашем тесте преимущество составило 54 раза против передовой модели, и это уже меняет расчёты любой организации.
То, что даёт только классификатор: уверенность
Самый полезный показатель теста не в таблице точности. Это уверенность, которую Jev возвращает в каждом ответе. С ней можно решать, когда ИИ сортирует сам, а когда смотрит аналитик:
| ИИ решает сам, когда уверенность не ниже | Заявок отсортировано автоматически | Точность на этих заявках | Уходят аналитику |
|---|---|---|---|
| 0,5 | 99,0% | 97,0% | 2 |
| 0,7 | 93,5% | 98,9% | 13 |
| 0,8 | 90,0% | 98,9% | 20 |
| 0,9 | 85,0% | 98,8% | 30 |
При пороге 0,7 93,5% заявок были бы отсортированы без участия человека с точностью 98,9%, а 13 из 200 ушли бы в очередь к людям. Пример того, что ловит этот порог: заявка «пришло письмо с просьбой ввести пароль, и двое коллег ввели пароль» — фишинговая атака — была классифицирована как почта с уверенностью 0,68. Ниже порога она попала бы к аналитику — именно туда, где ей и место.
LLM тоже могут вернуть «уверенность», если попросить, но это текст, который пишет модель, а не вычисленная вероятность. Для решений об автоматизации это имеет значение.
Где ошиблись все три
Ошибки говорят больше, чем верные ответы:
- Три заявки все три модели ошиблись одинаково. «Мой пользователь отображается с неправильным именем в Teams и в почте» (доступ или почта?), «выдать профиль согласующего в ERP» (доступ или ERP?) и «кадровая система не открывается после обновления» (ПО или ERP?). Во всех трёх наше собственное определение категорий допускает два прочтения. Урок: таксономия важнее модели. Прежде чем выбирать ИИ, пересмотрите категории.
- Срочность — слабое место у всех, около 15% ошибок, почти всегда на один уровень. Jev склонялся завышать срочность средних заявок и классифицировал как «высокую» две критические ситуации (полное падение интернета и недоступность ERP). GPT-5.6 Luna склонялся понижать средние до низких. Критическая срочность, затрагивающая несколько подразделений или выручку, требует бизнес-правила, а не только ИИ.
- На неоднозначных Jev оказался лучше (93,8% против 87,5% у обеих LLM).
Что это меняет для пользователей GLPI
GLPI уже решает значительную часть сортировки бизнес-правилами: ключевое слово в заголовке, источник заявки, форма. Проблема — заявка, пришедшая по почте и написанная так, как человек сумел её написать. Именно здесь вступает недорогой классификатор:
- Сначала правила. Всё, что можно решить правилом, решайте правилом: это предсказуемо и бесплатно. В NexTool модуль Ticket Rules сам категоризирует и заполняет заявку по правилам.
- Классификатор для остального, где порог уверенности решает, что уходит человеку.
- Назначение после верной категории. Когда категория определена, Smart Assign распределяет заявки между специалистами группы — по балансировке нагрузки или по очереди. Смотрите, как работает автоматическое назначение в GLPI.
- LLM там, где она незаменима: резюмировать историю, предлагать ответ и превращать решённую заявку в статью — это то, что делает AI Assist (ИИ для резюмирования заявок и ответов на них в GLPI).
Использовать передовую LLM для сортировки заявок — всё равно что звать эксперта разбирать почту: работает, но дорого и долго.
Прежде чем запускать в продуктив
- Собственные данные: в нашем тесте использовались вымышленные заявки на португальском, написанные нами. Прогоните такой же тест на выборке ваших заявок (анонимизированной), прежде чем доверять цифре.
- Калибровка: правильный порог уверенности зависит от вашей базы. Начните консервативно (0,8 или 0,9) и снижайте со временем.
- LGPD: текст заявки покидает вашу среду. Выбирайте провайдеров, которые не хранят данные, удаляйте персональные данные, когда это возможно, и фиксируйте это в оценке воздействия.
- Только один прогон: мы выполнили по одному запуску на модель, не подстраивая промпт и критерии под каждую.
Вывод
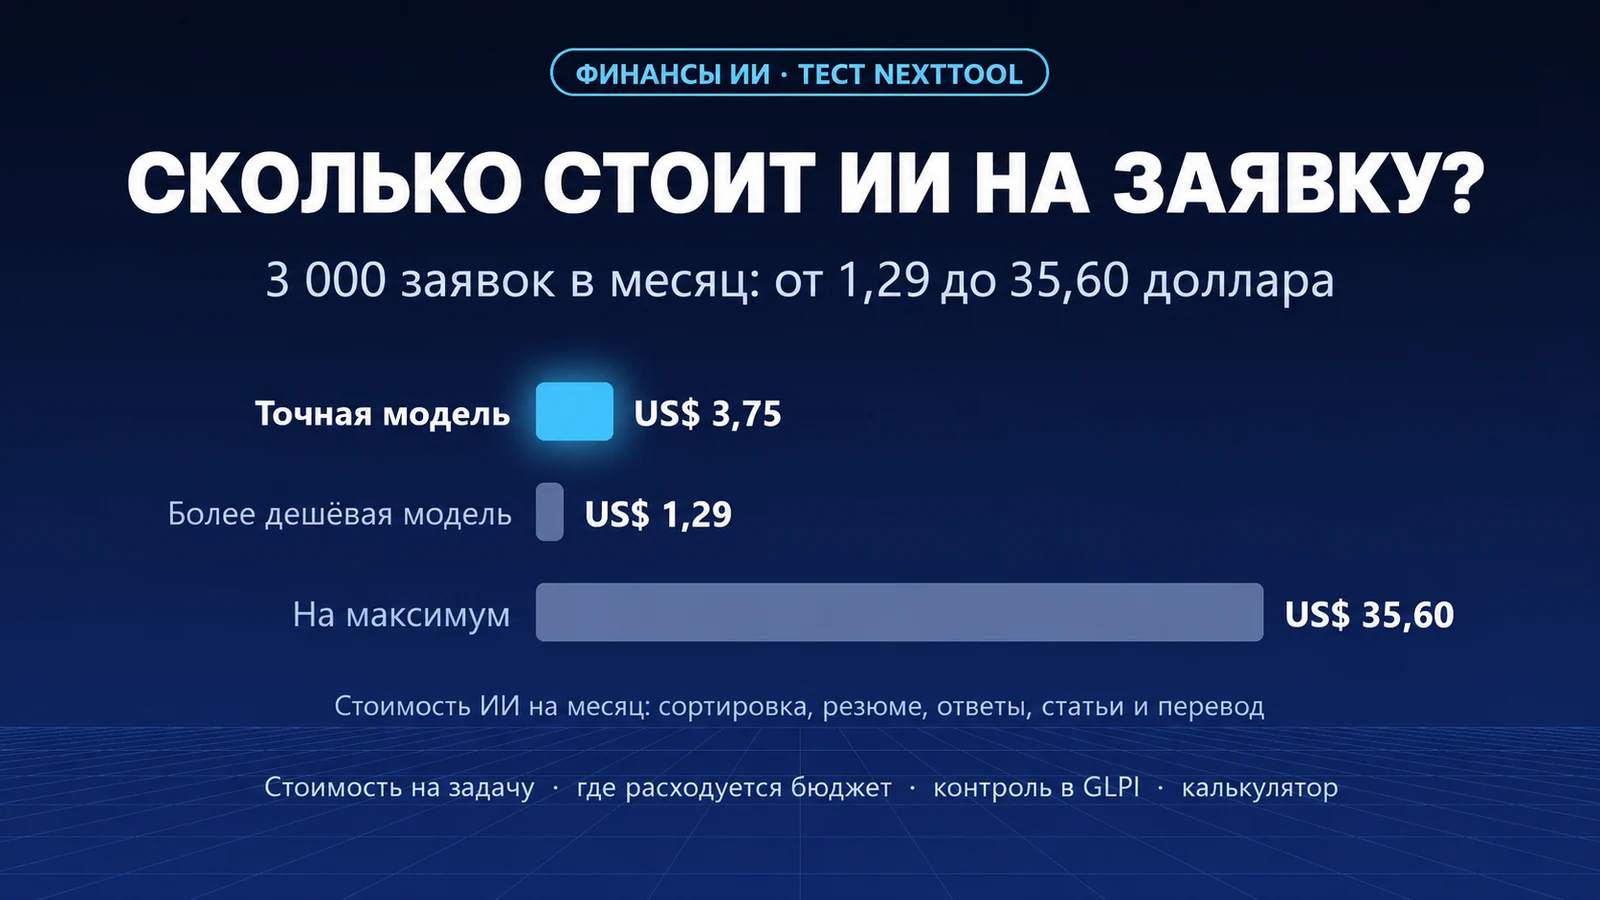
Для сортировки заявок самая дорогая модель не оказалась точнее. Три модели различались стоимостью, временем и откалиброванной уверенностью, которая позволяет безопасно автоматизировать. Правильный вопрос перед внедрением ИИ в службу поддержки — не «какая модель лучшая», а «какую задачу я решаю». В следующей статье мы используем эти цифры, чтобы ответить на другой вопрос: сколько стоит ИИ в расчёте на одну заявку.
Хотите пересмотреть сортировку и назначение заявок в вашем GLPI? Свяжитесь с командой.
Тест проведён командой NexTool Solutions 1 октября 2026 г. на 200 вымышленных заявках по ценам OpenRouter на эту дату. Модели: typesafe/jev-1.13, openai/gpt-5.6-luna и anthropic/claude-sonnet-5.5.