


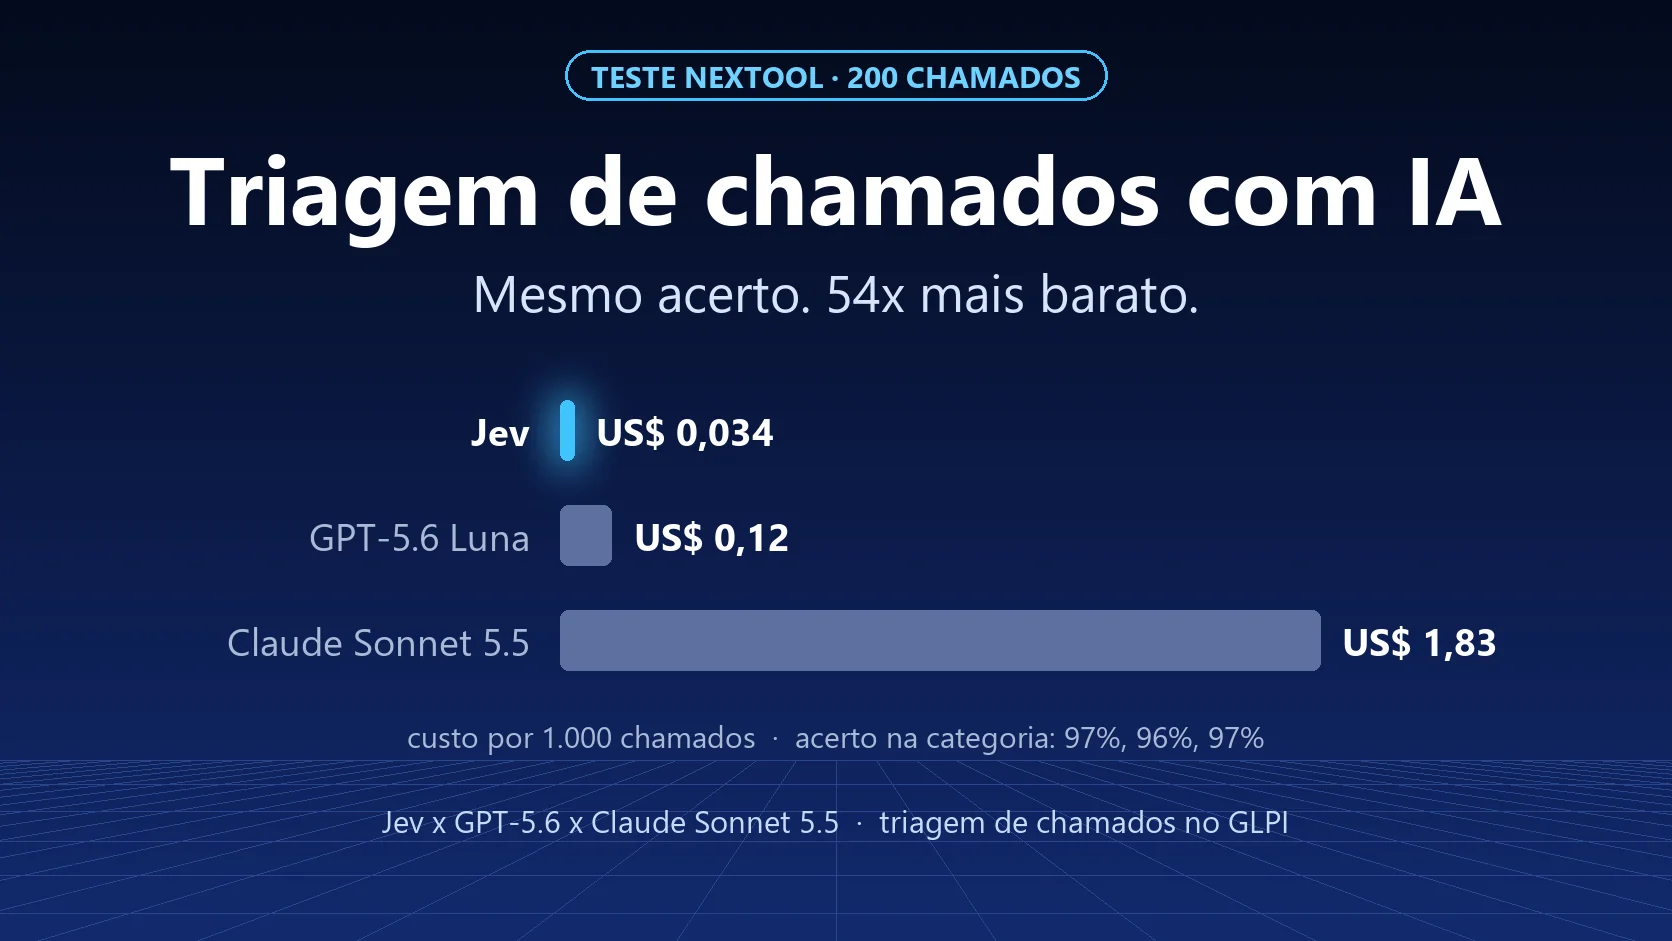
Clasificar mil tickets con IA costó US$ 0,034 con Jev, US$ 0,12 con GPT-5.6 Luna y US$ 1,83 con Claude Sonnet 5.5. Los tres acertaron la categoría entre el 96% y el 97% de las veces. Hicimos la prueba con 200 tickets de una mesa de ayuda ficticia para responder una pregunta que casi nadie se hace antes de poner IA en el soporte: para clasificar un ticket, ¿realmente necesita un modelo que escribe?
El cuello de botella que nadie mide: la clasificación
Cada ticket pasa por tres decisiones antes de que alguien empiece a resolverlo: cuál es la categoría, si es un incidente o una solicitud, y cuál es la urgencia. Cuando la clasificación falla, el ticket va a la cola equivocada, espera, se reclasifica y el SLA empieza a correr en contra del equipo. En muchas operaciones, esa clasificación todavía es manual, hecha por el primer nivel entre una atención y otra.
Es una tarea de decisión, no de redacción. Por eso el lanzamiento de Jev nos llamó la atención.
Qué es Jev y por qué es diferente
Jev fue lanzado por TypeSafe AI el 15 de septiembre de 2026 y está disponible en OpenRouter desde el 18 de septiembre. No genera texto. Usted envía el contexto (el texto del ticket) y preguntas tipadas, y devuelve:
- una elección entre opciones definidas (por ejemplo, la categoría);
- sí o no, con la probabilidad (por ejemplo, si es un incidente);
- una puntuación en una escala (por ejemplo, la urgencia).
Para cada respuesta informa la confianza. Y como no escribe, se paga básicamente por la entrada: US$ 0,042 por millón de tokens, según el fabricante. Un LLM, aunque solo se le pida un JSON corto, cobra entrada y salida y tarda más en responder.
Cómo hicimos la prueba
- 200 tickets ficticios de una empresa inventada, Acme: 25 por categoría (red, acceso, ERP, correo y Office, impresora, hardware, software, telefonía), escritos como escriben de verdad los usuarios, con prisa, abreviaturas y dos problemas en el mismo texto. Ningún dato real. Los tickets estaban en portugués.
- Respuestas correctas definidas antes de la prueba: la categoría, el tipo (incidente o solicitud) y la urgencia (baja, media, alta, crítica), con reglas escritas para cada nivel. Dieciséis tickets son ambiguos a propósito, de los que también harían dudar a un analista.
- Las mismas preguntas y definiciones para los tres modelos, vía OpenRouter, con temperatura cero y proveedores que no retienen datos: Jev 1.13, GPT-5.6 Luna (el modelo económico de OpenAI) y Claude Sonnet 5.5 (un modelo de punta de Anthropic).
- Medimos acierto, tiempo de respuesta y costo de cada llamada. La prueba completa costó unos US$ 0,40.
Los resultados
| Jev 1.13 | GPT-5.6 Luna | Claude Sonnet 5.5 | |
|---|---|---|---|
| Categoría correcta | 97,0% | 96,0% | 97,0% |
| Incidente o solicitud | 97,0% | 98,0% | 98,0% |
| Urgencia exacta | 83,5% | 85,0% | 84,5% |
| Urgencia con hasta 1 nivel de diferencia | 99,5% | 100% | 100% |
| Las tres respuestas correctas | 79,0% | 81,0% | 82,0% |
| Categoría en los 16 ambiguos | 93,8% | 87,5% | 87,5% |
| Tiempo de respuesta (mediana) | 0,66 s | 1,6 s | 2,1 s |
| Costo por 1.000 tickets | US$ 0,034 | US$ 0,12 | US$ 1,83 |

En acierto, empate técnico: la diferencia entre los tres es de uno o dos tickets de doscientos. En costo, Jev resultó 54 veces más barato que Claude Sonnet 5.5 y casi 4 veces más barato que GPT-5.6 Luna. En tiempo, respondió de 2,5 a 3 veces más rápido, y con poca variación: el 95% de las respuestas llegó en menos de 0,75 s.
TypeSafe anuncia un flujo "444 veces más barato que un LLM de punta". No reprodujimos esa cifra, y no es extraño: su comparación usa otra tarea y otro modelo. En nuestra prueba, la ventaja fue de 54 veces frente a un modelo de punta, lo que ya cambia las cuentas de cualquier operación.
Lo que solo el clasificador entrega: la confianza
El dato más útil de la prueba no está en la tabla de aciertos. Es la confianza que Jev devuelve en cada respuesta. Con ella se puede decidir cuándo la IA clasifica sola y cuándo lo revisa un analista:
| La IA decide sola cuando la confianza es de al menos | Tickets clasificados solos | Acierto en esos tickets | Van a un analista |
|---|---|---|---|
| 0,5 | 99,0% | 97,0% | 2 |
| 0,7 | 93,5% | 98,9% | 13 |
| 0,8 | 90,0% | 98,9% | 20 |
| 0,9 | 85,0% | 98,8% | 30 |
Con el corte en 0,7, el 93,5% de los tickets se clasificaría sin intervención humana, con un 98,9% de acierto, y 13 de 200 irían a la cola humana. Un ejemplo de lo que atrapa ese corte: el ticket "recibimos un correo pidiendo la contraseña y dos compañeros la escribieron", un ataque de phishing, se clasificó como correo con confianza 0,68. Por debajo del corte, iría a un analista, que es exactamente donde debe estar.
Los LLM también pueden devolver una "confianza" si se les pide, pero es un texto que el modelo escribe, no una probabilidad calculada. Para decidir la automatización, eso marca la diferencia.
Dónde se equivocaron los tres
Los errores dicen más que los aciertos:
- Tres tickets los tres modelos los fallaron igual. "Mi usuario aparece con el nombre equivocado en Teams y en el correo" (¿acceso o correo?), "habilitar el perfil de aprobador en el ERP" (¿acceso o ERP?) y "el sistema de RR. HH. no abre después de la actualización" (¿software o ERP?). En los tres, nuestra propia definición de categorías admite dos lecturas. La lección: la taxonomía pesa más que el modelo. Antes de elegir la IA, revise sus categorías.
- La urgencia es el punto débil de todos, con cerca de un 15% de error, casi siempre por un nivel. Jev tendió a subir la urgencia de tickets medios y calificó como "alta" dos situaciones críticas (caída general de internet y ERP fuera de servicio). GPT-5.6 Luna tendió a bajar los medios a bajos. La urgencia crítica, que afecta a varios sectores o a la facturación, necesita una regla de negocio, no solo IA.
- En los ambiguos, Jev fue mejor (93,8% frente a 87,5% de los dos LLM).
Qué cambia esto para quien usa GLPI
GLPI ya resuelve buena parte de la clasificación con reglas de negocio: palabra clave en el título, origen del ticket, formulario. El problema es el ticket que llega por correo, escrito como la persona pudo escribirlo. Ahí entra un clasificador de bajo costo:
- Primero las reglas. Lo que se puede decidir por regla, decídalo por regla: es predecible y gratis. En NexTool, el módulo Reglas de Ticket categoriza y completa el ticket solo, por reglas.
- Un clasificador para el resto, con el corte de confianza decidiendo qué va a un humano.
- Asignación después de la categoría correcta. Con la categoría definida, la Asignación Inteligente reparte los tickets entre los técnicos del grupo, por balanceo de carga o por turnos. Vea cómo funciona la asignación automática en GLPI.
- Un LLM donde es insustituible: resumir el historial, sugerir respuesta y convertir el ticket resuelto en artículo, que es lo que hace AI Assist (IA para resumir y responder tickets en GLPI).
Usar un LLM de punta para clasificar tickets es como llamar al especialista para ordenar la correspondencia: funciona, pero sale caro y tarda.
Antes de llevarlo a producción
- Datos propios: nuestra prueba usó tickets ficticios, en portugués, escritos por nosotros. Repita la prueba con una muestra de sus tickets (anonimizada) antes de confiar en la cifra.
- Calibración: el corte de confianza correcto depende de su base. Empiece de forma conservadora (0,8 o 0,9) y bájelo con el tiempo.
- Protección de datos: el texto del ticket sale de su entorno. Elija proveedores que no retengan datos, elimine los datos personales cuando sea posible y regístrelo en su evaluación de impacto.
- Una sola ronda: ejecutamos cada modelo una vez, sin ajustar prompt ni criterios para cada uno.
Conclusión
Para clasificar tickets, el modelo más caro no acertó más. Lo que separó a los tres fue el costo, el tiempo y la confianza calibrada, que permite automatizar con seguridad. La pregunta correcta antes de poner IA en la mesa de ayuda no es "cuál es el mejor modelo", sino "qué tarea estoy resolviendo". En el próximo artículo usamos estos números para responder otra: cuánto cuesta la IA por ticket.
¿Quiere revisar la clasificación y la asignación de su GLPI? Hable con el equipo.
Prueba realizada por el equipo de NexTool Solutions el 1 de octubre de 2026, con 200 tickets ficticios y precios de OpenRouter en esa fecha. Modelos: typesafe/jev-1.13, openai/gpt-5.6-luna y anthropic/claude-sonnet-5.5.



