


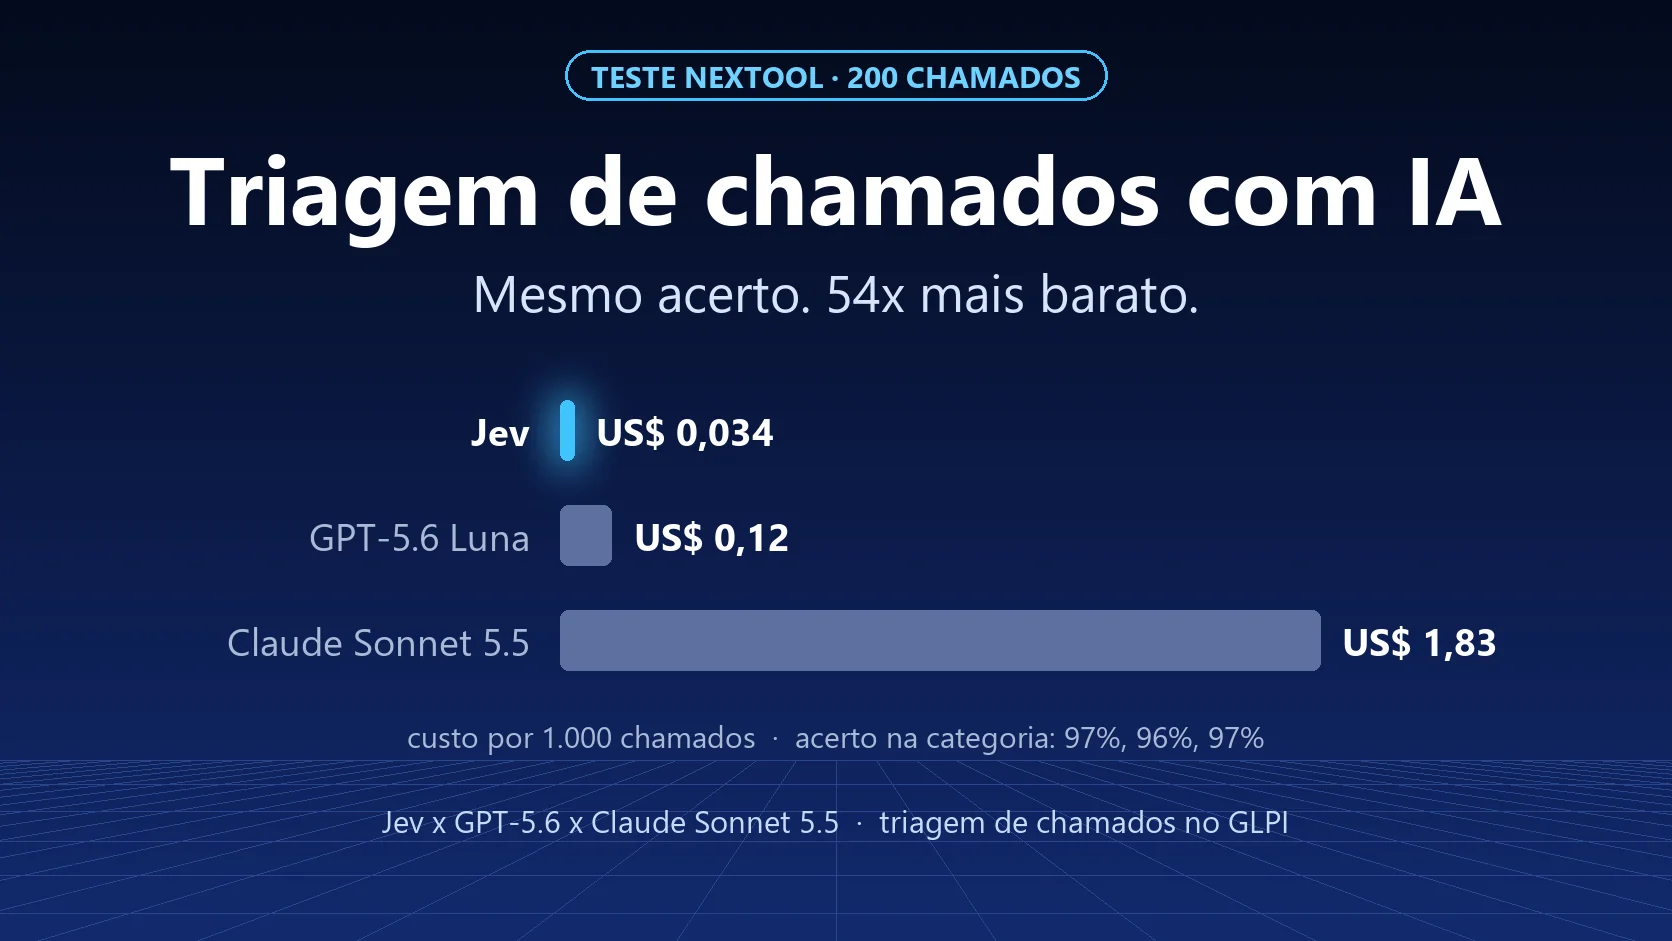
Classer mille tickets avec l'IA a coûté 0,034 US$ avec Jev, 0,12 US$ avec GPT-5.6 Luna et 1,83 US$ avec Claude Sonnet 5.5. Les trois ont trouvé la bonne catégorie dans 96 % à 97 % des cas. Nous avons mené le test sur 200 tickets d'un service desk fictif pour répondre à une question que presque personne ne se pose avant d'ajouter l'IA au support : pour trier un ticket, faut-il vraiment un modèle qui écrit ?
Le goulot d'étranglement que personne ne mesure : le tri
Chaque ticket passe par trois décisions avant que quelqu'un ne commence à le traiter : sa catégorie, s'il s'agit d'un incident ou d'une demande, et son urgence. Quand le tri se trompe, le ticket part dans la mauvaise file, attend, est reclassé, et le SLA tourne contre l'équipe. Dans beaucoup d'organisations, ce tri est encore manuel, fait par le niveau 1 entre deux appels.
C'est une tâche de décision, pas de rédaction. C'est pourquoi le lancement de Jev a retenu notre attention.
Ce qu'est Jev et pourquoi il est différent
Jev a été lancé par TypeSafe AI le 15 septembre 2026 et est disponible sur OpenRouter depuis le 18 septembre. Il ne génère pas de texte. Vous envoyez le contexte (le texte du ticket) et des questions typées, et il renvoie :
- un choix parmi des options définies (par exemple, la catégorie) ;
- oui ou non, avec la probabilité (par exemple, s'il s'agit d'un incident) ;
- une note sur une échelle (par exemple, l'urgence).
Pour chaque réponse, il indique la confiance. Et comme il n'écrit pas, vous payez essentiellement l'entrée : 0,042 US$ par million de tokens, selon l'éditeur. Un LLM, même quand on lui demande seulement un JSON court, facture l'entrée et la sortie et met plus de temps à répondre.
Comment nous avons mené le test
- 200 tickets fictifs d'une entreprise inventée, Acme : 25 par catégorie (réseau, accès, ERP, messagerie et Office, imprimante, matériel, logiciel, téléphonie), rédigés comme les utilisateurs écrivent vraiment, dans l'urgence, avec des abréviations et deux problèmes dans le même texte. Aucune donnée réelle. Les tickets étaient rédigés en portugais.
- Réponses attendues définies avant le test : la catégorie, le type (incident ou demande) et l'urgence (basse, moyenne, haute, critique), avec des règles écrites pour chaque niveau. Seize tickets sont ambigus volontairement, de ceux qui feraient hésiter un analyste.
- Les mêmes questions et définitions pour les trois modèles, via OpenRouter, température à zéro et fournisseurs sans conservation des données : Jev 1.13, GPT-5.6 Luna (le modèle économique d'OpenAI) et Claude Sonnet 5.5 (un modèle de pointe d'Anthropic).
- Nous avons mesuré la précision, le temps de réponse et le coût de chaque appel. Le test complet a coûté environ 0,40 US$.
Les résultats
| Jev 1.13 | GPT-5.6 Luna | Claude Sonnet 5.5 | |
|---|---|---|---|
| Bonne catégorie | 97,0 % | 96,0 % | 97,0 % |
| Incident ou demande | 97,0 % | 98,0 % | 98,0 % |
| Urgence exacte | 83,5 % | 85,0 % | 84,5 % |
| Urgence à 1 niveau près | 99,5 % | 100 % | 100 % |
| Les trois réponses justes | 79,0 % | 81,0 % | 82,0 % |
| Catégorie sur les 16 tickets ambigus | 93,8 % | 87,5 % | 87,5 % |
| Temps de réponse (médiane) | 0,66 s | 1,6 s | 2,1 s |
| Coût pour 1 000 tickets | 0,034 US$ | 0,12 US$ | 1,83 US$ |

En précision, égalité technique : l'écart entre les trois est d'un ou deux tickets sur deux cents. En coût, Jev s'est révélé 54 fois moins cher que Claude Sonnet 5.5 et presque 4 fois moins cher que GPT-5.6 Luna. En temps, il a répondu 2,5 à 3 fois plus vite, avec peu de variation : 95 % des réponses sont arrivées en moins de 0,75 s.
TypeSafe annonce un workflow « 444 fois moins cher qu'un LLM de pointe ». Nous n'avons pas reproduit ce chiffre, et ce n'est pas étonnant : sa comparaison porte sur une autre tâche et un autre modèle. Dans notre test, l'avantage a été de 54 fois face à un modèle de pointe, ce qui change déjà les calculs de n'importe quelle organisation.
Ce que seul le classificateur apporte : la confiance
Le résultat le plus utile du test n'est pas dans le tableau de précision. C'est la confiance que Jev renvoie à chaque réponse. Avec elle, on peut décider quand l'IA trie seule et quand un analyste vérifie :
| L'IA décide seule quand la confiance est d'au moins | Tickets triés automatiquement | Précision sur ces tickets | Envoyés à un analyste |
|---|---|---|---|
| 0,5 | 99,0 % | 97,0 % | 2 |
| 0,7 | 93,5 % | 98,9 % | 13 |
| 0,8 | 90,0 % | 98,9 % | 20 |
| 0,9 | 85,0 % | 98,8 % | 30 |
Avec un seuil à 0,7, 93,5 % des tickets seraient triés sans intervention, avec 98,9 % de précision, et 13 sur 200 iraient vers la file humaine. Un exemple de ce que ce seuil intercepte : le ticket « nous avons reçu un e-mail demandant le mot de passe et deux collègues l'ont saisi », une attaque de phishing, a été classé en messagerie avec une confiance de 0,68. Sous le seuil, il serait passé à un analyste, exactement là où il doit être.
Les LLM peuvent aussi renvoyer une « confiance » si on la leur demande, mais c'est un texte que le modèle écrit, pas une probabilité calculée. Pour décider d'automatiser, cela fait une différence.
Là où les trois se sont trompés
Les erreurs en disent plus que les réussites :
- Trois tickets ont été ratés de la même façon par les trois modèles. « Mon utilisateur apparaît avec un mauvais nom dans Teams et dans la messagerie » (accès ou messagerie ?), « activer le profil d'approbateur dans l'ERP » (accès ou ERP ?) et « le logiciel RH ne s'ouvre plus après la mise à jour » (logiciel ou ERP ?). Dans les trois cas, notre propre définition des catégories permet deux lectures. La leçon : la taxonomie compte plus que le modèle. Avant de choisir l'IA, revoyez vos catégories.
- L'urgence est le point faible de tous, avec environ 15 % d'erreur, presque toujours d'un niveau. Jev a eu tendance à relever l'urgence des tickets moyens et a classé en « haute » deux situations critiques (coupure internet générale et ERP indisponible). GPT-5.6 Luna a eu tendance à baisser les moyens en bas. L'urgence critique, qui touche plusieurs services ou la facturation, demande une règle métier, pas seulement de l'IA.
- Sur les tickets ambigus, Jev a fait mieux (93,8 % contre 87,5 % pour les deux LLM).
Ce que cela change pour les utilisateurs de GLPI
GLPI gère déjà une bonne partie du tri avec les règles métier : mot-clé dans le titre, source du ticket, formulaire. Le problème, c'est le ticket qui arrive par e-mail, rédigé comme la personne a pu le rédiger. C'est là qu'un classificateur à faible coût intervient :
- D'abord les règles. Ce qui peut être décidé par une règle doit l'être : c'est prévisible et gratuit. Dans NexTool, le module Règles de ticket catégorise et complète le ticket automatiquement par règles.
- Un classificateur pour le reste, le seuil de confiance décidant de ce qui va à un humain.
- L'attribution après la bonne catégorie. Une fois la catégorie définie, l'Attribution intelligente répartit les tickets entre les techniciens du groupe, par équilibrage de charge ou à tour de rôle. Voir comment fonctionne l'attribution automatique dans GLPI.
- Un LLM là où il est irremplaçable : résumer l'historique, suggérer une réponse et transformer le ticket résolu en article, ce que fait AI Assist (l'IA pour résumer et répondre aux tickets dans GLPI).
Utiliser un LLM de pointe pour trier des tickets, c'est comme appeler l'expert pour trier le courrier : ça marche, mais c'est cher et lent.
Avant la mise en production
- Vos propres données : notre test a utilisé des tickets fictifs, en portugais, rédigés par nous. Refaites le test avec un échantillon de vos tickets (anonymisé) avant de vous fier au chiffre.
- Calibrage : le bon seuil de confiance dépend de votre base. Commencez prudemment (0,8 ou 0,9) et abaissez-le avec le temps.
- RGPD : le texte du ticket sort de votre environnement. Choisissez des fournisseurs sans conservation des données, retirez les données personnelles quand c'est possible et consignez-le dans votre analyse d'impact.
- Une seule exécution : nous avons lancé chaque modèle une fois, sans ajuster le prompt ni les critères pour chacun.
Conclusion
Pour trier les tickets, le modèle le plus cher n'a pas été plus précis. Ce qui a départagé les trois, c'est le coût, le temps et la confiance calibrée, qui permet d'automatiser en sécurité. La bonne question avant d'ajouter l'IA au service desk n'est pas « quel est le meilleur modèle », mais « quelle tâche est-ce que je résous ». Dans le prochain article, nous utilisons ces chiffres pour répondre à une autre question : combien coûte l'IA par ticket.
Vous voulez revoir le tri et l'attribution de votre GLPI ? Parlez à l'équipe.
Test réalisé par l'équipe NexTool Solutions le 1er octobre 2026, avec 200 tickets fictifs et les prix d'OpenRouter à cette date. Modèles : typesafe/jev-1.13, openai/gpt-5.6-luna et anthropic/claude-sonnet-5.5.



