


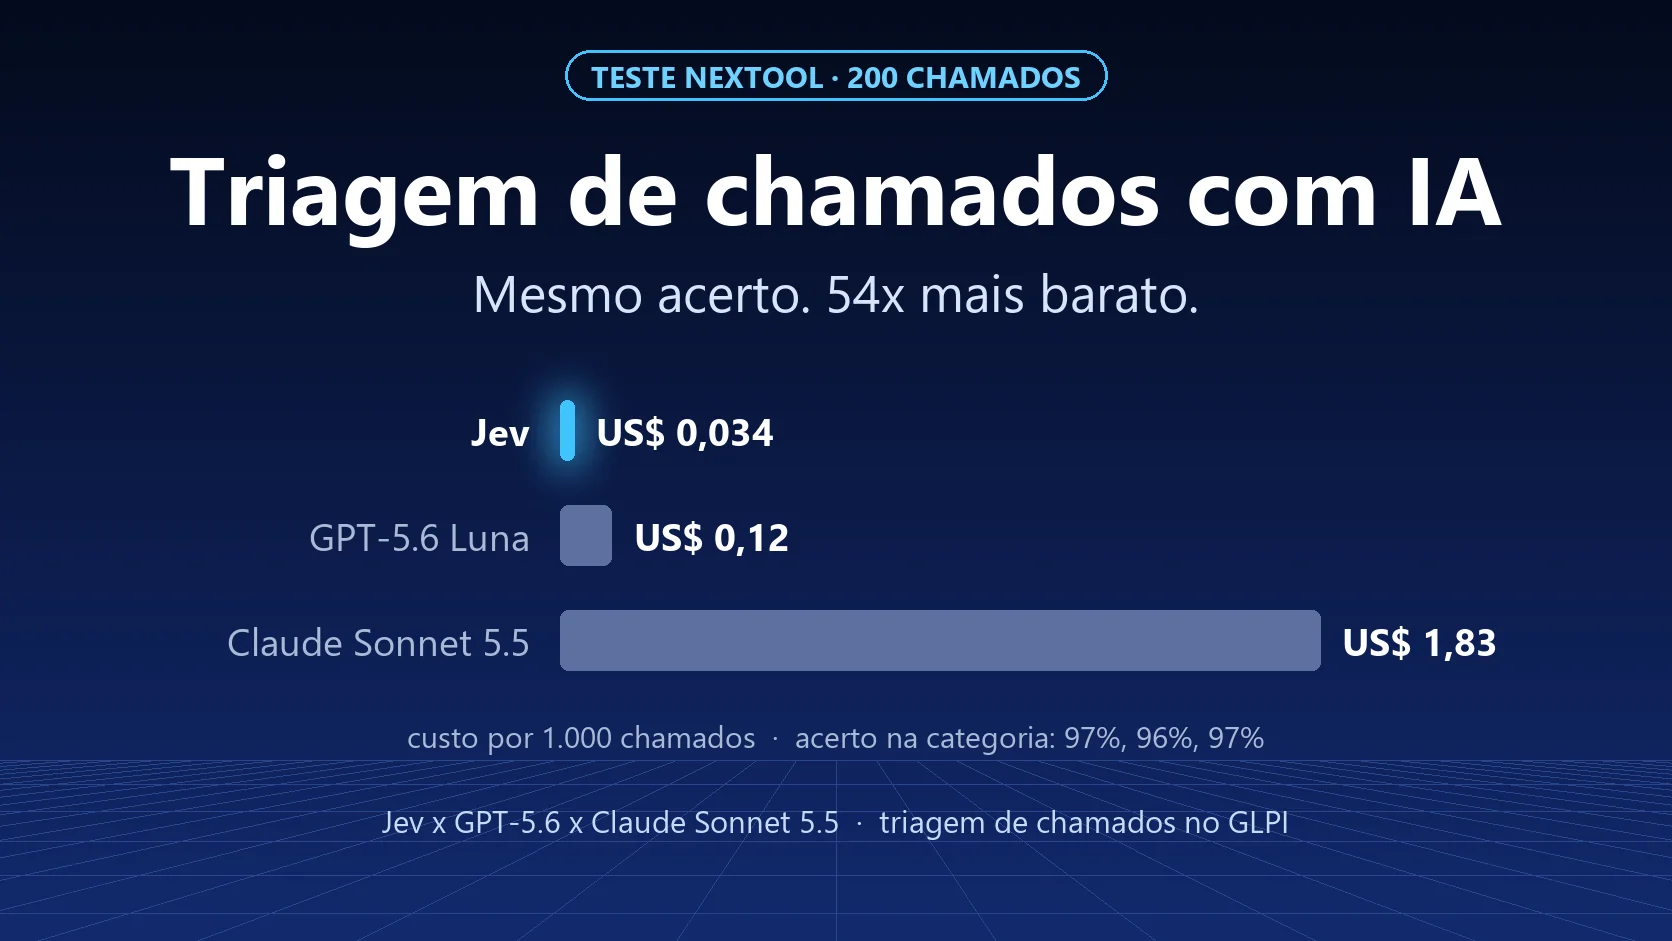
Classificare mille ticket con l'IA è costato 0,034 US$ con Jev, 0,12 US$ con GPT-5.6 Luna e 1,83 US$ con Claude Sonnet 5.5. Tutti e tre hanno indovinato la categoria nel 96-97% dei casi. Abbiamo fatto il test con 200 ticket di un service desk fittizio per rispondere a una domanda che quasi nessuno si pone prima di portare l'IA nel supporto: per smistare un ticket serve davvero un modello che scrive?
Il collo di bottiglia che nessuno misura: lo smistamento
Ogni ticket passa per tre decisioni prima che qualcuno inizi a lavorarci: la categoria, se è un incidente o una richiesta, e l'urgenza. Quando lo smistamento sbaglia, il ticket finisce nella coda sbagliata, aspetta, viene riclassificato e lo SLA corre contro il team. In molte realtà lo smistamento è ancora manuale, fatto dal primo livello tra una chiamata e l'altra.
È un compito di decisione, non di scrittura. Per questo il lancio di Jev ha attirato la nostra attenzione.
Cos'è Jev e perché è diverso
Jev è stato lanciato da TypeSafe AI il 15 settembre 2026 ed è disponibile su OpenRouter dal 18 settembre. Non genera testo. Si invia il contesto (il testo del ticket) e delle domande tipizzate, e restituisce:
- una scelta tra opzioni definite (per esempio, la categoria);
- sì o no, con la probabilità (per esempio, se è un incidente);
- un punteggio su una scala (per esempio, l'urgenza).
Per ogni risposta indica la confidenza. E siccome non scrive, si paga sostanzialmente l'input: 0,042 US$ per milione di token, secondo il produttore. Un LLM, anche quando gli si chiede solo un JSON breve, fa pagare input e output e impiega più tempo a rispondere.
Come abbiamo fatto il test
- 200 ticket fittizi di un'azienda inventata, Acme: 25 per categoria (rete, accessi, ERP, e-mail e Office, stampanti, hardware, software, telefonia), scritti come scrivono davvero gli utenti, di fretta, con abbreviazioni e due problemi nello stesso testo. Nessun dato reale. I ticket erano in portoghese.
- Risposte corrette definite prima del test: la categoria, il tipo (incidente o richiesta) e l'urgenza (bassa, media, alta, critica), con regole scritte per ogni livello. Sedici ticket sono ambigui di proposito, di quelli che farebbero esitare anche un analista.
- Le stesse domande e definizioni per i tre modelli, tramite OpenRouter, con temperatura zero e fornitori che non conservano i dati: Jev 1.13, GPT-5.6 Luna (il modello economico di OpenAI) e Claude Sonnet 5.5 (un modello di punta di Anthropic).
- Abbiamo misurato accuratezza, tempo di risposta e costo di ogni chiamata. L'intero test è costato circa 0,40 US$.
I risultati
| Jev 1.13 | GPT-5.6 Luna | Claude Sonnet 5.5 | |
|---|---|---|---|
| Categoria corretta | 97,0% | 96,0% | 97,0% |
| Incidente o richiesta | 97,0% | 98,0% | 98,0% |
| Urgenza esatta | 83,5% | 85,0% | 84,5% |
| Urgenza entro 1 livello | 99,5% | 100% | 100% |
| Tutte e tre le risposte corrette | 79,0% | 81,0% | 82,0% |
| Categoria nei 16 ticket ambigui | 93,8% | 87,5% | 87,5% |
| Tempo di risposta (mediana) | 0,66 s | 1,6 s | 2,1 s |
| Costo per 1.000 ticket | 0,034 US$ | 0,12 US$ | 1,83 US$ |

Nell'accuratezza, pareggio tecnico: la differenza tra i tre è di uno o due ticket su duecento. Nel costo, Jev è risultato 54 volte più economico di Claude Sonnet 5.5 e quasi 4 volte più economico di GPT-5.6 Luna. Nel tempo, ha risposto da 2,5 a 3 volte più velocemente, con poca variazione: il 95% delle risposte è arrivato in meno di 0,75 s.
TypeSafe annuncia un flusso "444 volte più economico di un LLM di punta". Non abbiamo riprodotto quel numero, e non è strano: il loro confronto usa un altro compito e un altro modello. Nel nostro test, il vantaggio è stato di 54 volte rispetto a un modello di punta, il che cambia già i conti di qualsiasi realtà.
Ciò che solo il classificatore offre: la confidenza
Il dato più utile del test non è nella tabella dell'accuratezza. È la confidenza che Jev restituisce con ogni risposta. Con essa si può decidere quando l'IA smista da sola e quando un analista controlla:
| L'IA decide da sola quando la confidenza è almeno | Ticket smistati automaticamente | Accuratezza su quei ticket | Inviati a un analista |
|---|---|---|---|
| 0,5 | 99,0% | 97,0% | 2 |
| 0,7 | 93,5% | 98,9% | 13 |
| 0,8 | 90,0% | 98,9% | 20 |
| 0,9 | 85,0% | 98,8% | 30 |
Con la soglia a 0,7, il 93,5% dei ticket verrebbe smistato senza intervento umano, con il 98,9% di accuratezza, e 13 su 200 andrebbero alla coda umana. Un esempio di ciò che quella soglia intercetta: il ticket "abbiamo ricevuto un'e-mail che chiedeva la password e due colleghi l'hanno inserita", un attacco di phishing, è stato classificato come e-mail con confidenza 0,68. Sotto la soglia, finirebbe a un analista, esattamente dove deve stare.
Anche gli LLM possono restituire una "confidenza" se gliela si chiede, ma è un testo scritto dal modello, non una probabilità calcolata. Per decidere l'automazione, fa la differenza.
Dove hanno sbagliato tutti e tre
Gli errori dicono più dei successi:
- Tre ticket sono stati sbagliati allo stesso modo da tutti e tre i modelli. "Il mio utente compare con il nome sbagliato in Teams e nell'e-mail" (accessi o e-mail?), "abilitare il profilo di approvatore nell'ERP" (accessi o ERP?) e "il sistema HR non si apre dopo l'aggiornamento" (software o ERP?). In tutti e tre, la nostra stessa definizione delle categorie ammette due letture. La lezione: la tassonomia conta più del modello. Prima di scegliere l'IA, riveda le categorie.
- L'urgenza è il punto debole di tutti, con circa il 15% di errore, quasi sempre di un livello. Jev ha teso ad alzare l'urgenza dei ticket medi e ha classificato come "alta" due situazioni critiche (caduta generale di internet ed ERP fuori servizio). GPT-5.6 Luna ha teso ad abbassare i medi a bassi. L'urgenza critica, che colpisce più reparti o la fatturazione, richiede una regola di business, non solo IA.
- Sui ticket ambigui, Jev è andato meglio (93,8% contro 87,5% dei due LLM).
Cosa cambia per chi usa GLPI
GLPI risolve già buona parte dello smistamento con le regole di business: parola chiave nel titolo, origine del ticket, modulo. Il problema è il ticket che arriva via e-mail, scritto come la persona è riuscita a scriverlo. È lì che entra un classificatore a basso costo:
- Prima le regole. Ciò che si può decidere con una regola, lo decida con una regola: è prevedibile e gratuito. In NexTool, il modulo Regole dei ticket categorizza e compila il ticket da solo, tramite regole.
- Un classificatore per il resto, con la soglia di confidenza che decide cosa va a un umano.
- L'assegnazione dopo la categoria giusta. Definita la categoria, l'Assegnazione intelligente distribuisce i ticket tra i tecnici del gruppo, per bilanciamento del carico o a rotazione. Veda come funziona l'assegnazione automatica in GLPI.
- Un LLM dove è insostituibile: riassumere lo storico, suggerire la risposta e trasformare il ticket risolto in articolo, che è ciò che fa AI Assist (IA per riassumere e rispondere ai ticket in GLPI).
Usare un LLM di punta per smistare i ticket è come chiamare lo specialista per smistare la posta: funziona, ma costa caro ed è lento.
Prima di andare in produzione
- Dati propri: il nostro test ha usato ticket fittizi, in portoghese, scritti da noi. Ripeta il test con un campione dei Suoi ticket (anonimizzato) prima di fidarsi del numero.
- Calibrazione: la soglia di confidenza giusta dipende dai Suoi dati. Inizi in modo prudente (0,8 o 0,9) e la abbassi col tempo.
- GDPR: il testo del ticket esce dal Suo ambiente. Scelga fornitori che non conservano i dati, rimuova i dati personali quando possibile e lo registri nella Sua valutazione d'impatto.
- Una sola esecuzione: abbiamo eseguito ogni modello una volta, senza adattare prompt né criteri per ciascuno.
Conclusione
Per smistare i ticket, il modello più costoso non è stato più accurato. Ciò che ha distinto i tre è stato il costo, il tempo e la confidenza calibrata, che permette di automatizzare in sicurezza. La domanda giusta prima di portare l'IA nel service desk non è "qual è il modello migliore", ma "quale compito sto risolvendo". Nel prossimo articolo usiamo questi numeri per rispondere a un'altra domanda: quanto costa l'IA per ticket.
Vuole rivedere lo smistamento e l'assegnazione del Suo GLPI? Parli con il team.
Test eseguito dal team di NexTool Solutions il 1° ottobre 2026, con 200 ticket fittizi e i prezzi di OpenRouter a quella data. Modelli: typesafe/jev-1.13, openai/gpt-5.6-luna e anthropic/claude-sonnet-5.5.



