


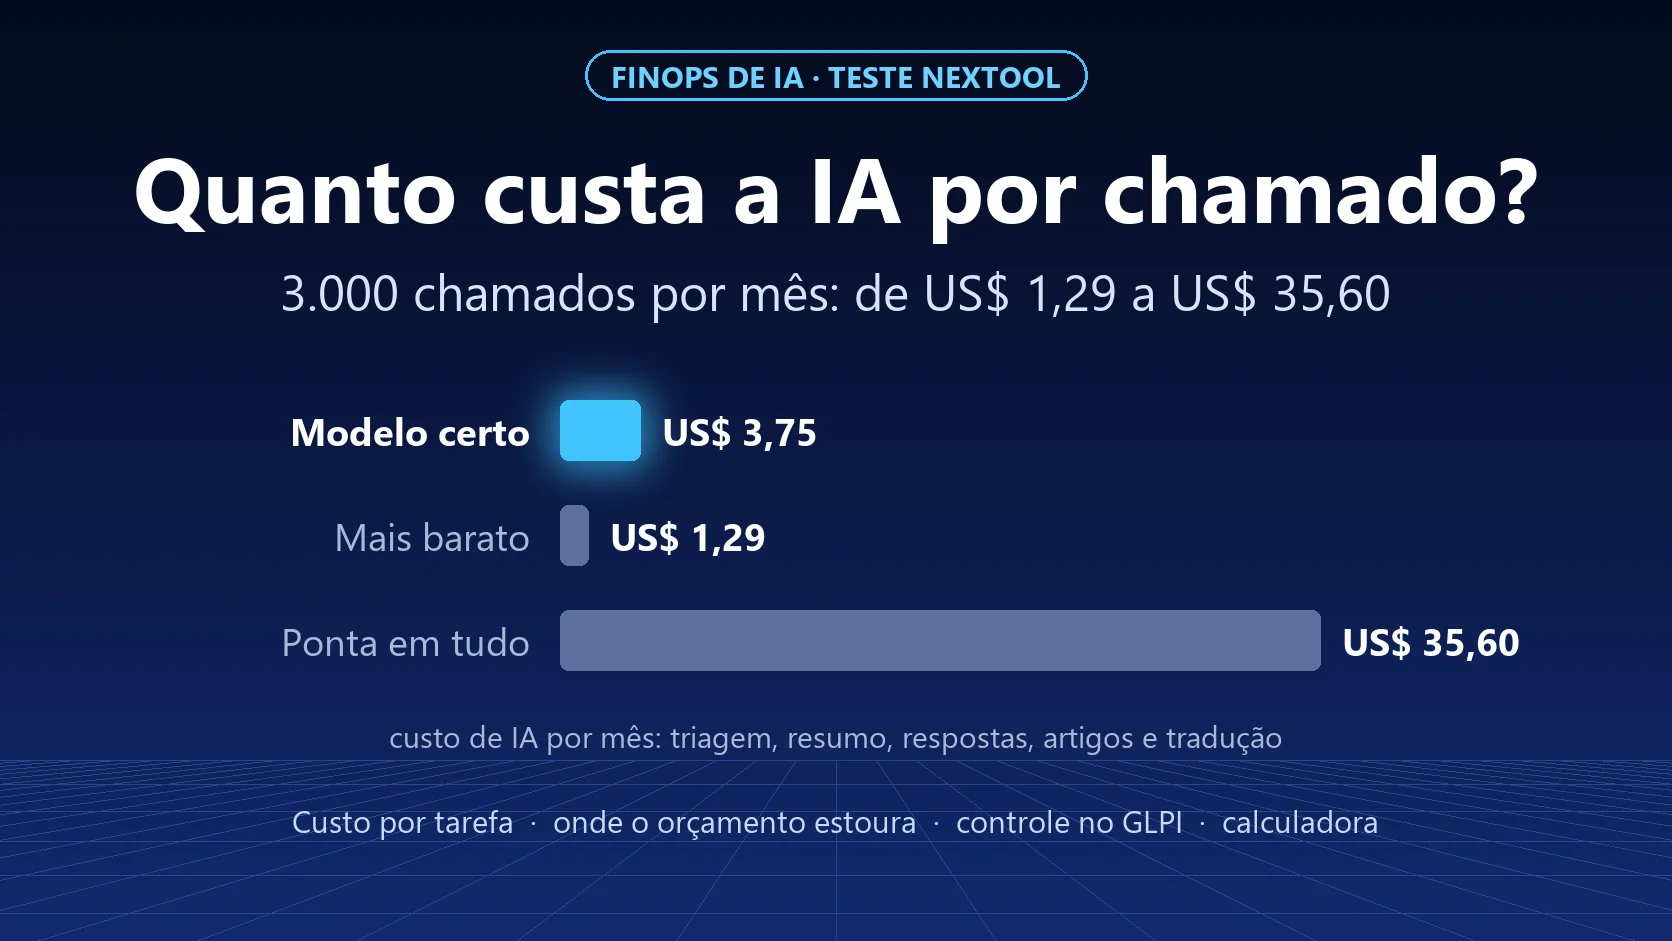
Mettre de l'IA sur 3 000 tickets par mois a coûté entre 1,29 US$ et 35,60 US$ dans notre test. L'écart de près de 28 fois ne venait pas de la qualité : il venait uniquement du modèle choisi pour chaque tâche. Et pourtant, 98 % des équipes FinOps gèrent déjà des dépenses d'IA, et la plupart n'arrivent pas à les prévoir. Le problème est rarement le prix du token. C'est de ne pas savoir combien coûte chaque ticket.
Cet article fait suite à Tri des tickets sans LLM : nous avons testé Jev et mesuré le coût pour mille tickets, où nous avons comparé trois modèles sur le tri de 200 tickets.
FinOps : du cloud à l'IA
Le FinOps est la pratique qui donne de la visibilité et un responsable aux dépenses technologiques : qui dépense, combien, pour quoi, et si cela en vaut la peine. Né pour la facture du cloud, il arrive maintenant à l'IA. Le rapport State of FinOps 2026 de la FinOps Foundation a interrogé 1 192 professionnels : 98 % gèrent déjà des dépenses d'IA, contre 31 % deux ans plus tôt. Des analyses du même rapport indiquent que la plupart des entreprises ont dépassé leurs prévisions de coût d'IA l'année dernière.
La cause est presque toujours la même : l'IA est facturée à l'usage (tokens), mais planifiée comme un abonnement. Personne ne sait dire combien coûte le résumé d'un ticket, donc personne ne sait dire combien coûtera le mois.
Le calcul que personne ne fait : le coût de chaque tâche
Nous l'avons mesuré. Nous avons pris 10 tickets fictifs avec un historique complet (ouverture, suivis et solution, de 4 à 8 messages chacun) et demandé quatre tâches à trois modèles, via OpenRouter, aux prix publics du 1er octobre 2026 :
| Tâche (coût pour 1 000 utilisations) | GPT-5.6 Luna | Gemini 3.5 Flash-Lite | Claude Sonnet 5.5 |
|---|---|---|---|
| Résumer l'historique | 0,15 US$ | 0,29 US$ | 3,22 US$ |
| Suggérer la prochaine réponse | 0,11 US$ | 0,20 US$ | 2,95 US$ |
| Rédiger un article de base de connaissances | 0,34 US$ | 0,65 US$ | 8,54 US$ |
| Traduire le dernier message | 0,10 US$ | 0,11 US$ | 1,30 US$ |
Et, d'après le test précédent, le tri (catégorie, type et urgence) : 0,034 US$ pour mille tickets avec Jev, 0,12 US$ avec GPT-5.6 Luna et 1,83 US$ avec Claude Sonnet 5.5.
Deux détails que le tableau cache :
- Le modèle de pointe écrit davantage. Sur l'article, Claude Sonnet 5.5 a produit en moyenne 789 tokens de réponse, contre 255 pour GPT-5.6 Luna. La sortie est la partie chère du token ; un texte plus long coûte plus, même s'il est meilleur.
- On paie même la réponse qui n'arrive pas. Sur un ticket de ransomware, Sonnet a utilisé les 300 tokens autorisés pour raisonner et a renvoyé une réponse vide. L'appel a été facturé quand même.
Trois scénarios pour 3 000 tickets par mois
Nous avons modélisé un service desk type : chaque ticket est trié, son historique est résumé une fois et il reçoit deux suggestions de réponse ; 10 % deviennent un article de base de connaissances et 5 % nécessitent une traduction.

| Scénario | Coût par ticket | Par mois (3 000 tickets) | Par an |
|---|---|---|---|
| Tout sur le modèle de pointe (Claude Sonnet 5.5) | 0,0119 US$ | 35,60 US$ | 427 US$ |
| Le bon modèle pour chaque tâche (Jev pour le tri, GPT-5.6 Luna au quotidien, Sonnet seulement pour l'article) | 0,0013 US$ | 3,75 US$ | 45 US$ |
| Tout sur le modèle le moins cher (Jev + GPT-5.6 Luna) | 0,0004 US$ | 1,29 US$ | 16 US$ |
Le scénario du milieu est celui que nous recommandons : le modèle de pointe reste là où la qualité de rédaction compte (l'article qui entre dans la base), et le reste va à des modèles rapides et économiques. Le coût est divisé par 9,5.
Remarquez l'ordre de grandeur : même le scénario le plus cher coûte quelques centimes par ticket. Si l'IA fait gagner une minute à l'analyste sur chaque ticket, elle est largement rentabilisée.
Là où le budget IA explose vraiment
Si le coût par ticket est si faible, pourquoi tant d'entreprises dépassent-elles leur budget ? Parce que la fuite est rarement dans le ticket :
- Des licences par utilisateur que personne n'utilise. Les assistants d'IA vendus au siège sont facturés chaque mois, utilisés ou non. C'est le même problème de licences inactives que le FinOps connaît déjà dans le cloud.
- Le modèle de pointe partout. Dans notre test, cela a multiplié le coût par 9,5 sans gain sur le tri.
- Trop de contexte. Envoyer tout l'historique, les pièces jointes et les signatures d'e-mail à l'IA à chaque clic fait croître le coût avec la taille du ticket, pas avec la valeur de la tâche.
- Un raisonnement sans limite. Les modèles qui « réfléchissent » avant de répondre facturent cette réflexion. Sans limite de tokens, une tâche simple peut coûter autant qu'une tâche complexe, ou ne rien livrer.
- Des agents en boucle. Un agent qui essaie, échoue et recommence peut faire des centaines d'appels sans que personne ne le voie.
- Un usage subventionné qui va s'arrêter. Les abonnements d'IA livrent aujourd'hui bien plus qu'ils ne coûtent. Chez NexTool, en 30 jours de développement, nous avons consommé environ 3,9 milliards de tokens : à peu près 15 000 R$ au prix public, couverts par un abonnement d'environ 200 US$. Ceux qui planifient l'avenir sur un prix subventionné auront une surprise quand il changera.
Mesurer sans se compliquer
Quatre chiffres suffisent pour commencer :
- Le coût d'IA par ticket résolu, ventilé par tâche (tri, résumé, réponse, article).
- Les tokens par tâche, pour repérer la tâche qui envoie trop de contexte.
- La part de tickets aidés par l'IA, pour savoir si la dépense suit l'usage.
- Le temps d'analyste économisé, même estimé, pour le comparer au coût.
Et trois garde-fous simples :
- Une limite de dépense par clé d'API. Pour notre test, nous avons utilisé une clé plafonnée à 10 US$ ; si quelque chose tourne mal, le préjudice est limité.
- Une limite de tokens par tâche, avec assez de marge pour que le modèle réponde (le cas du ransomware montre ce qui arrive quand elle manque).
- Un modèle par tâche, configuré et revu, au lieu du « meilleur modèle partout ».
Piloter la dépense IA dans GLPI
GLPI dispose déjà de quoi traiter l'IA comme n'importe quel autre coût informatique, sans nouvel outil :
- Contrats : enregistrez le contrat de chaque fournisseur d'IA, avec montant, période, reconduction et alerte d'échéance.
- Licences : enregistrez les sièges d'assistants d'IA comme licences, avec la quantité et leurs attributaires. Une licence sans utilisateur apparaît immédiatement.
- Budgets : créez un budget IA par entité ou service et rattachez-y les contrats.
- Fournisseurs : centralisez fournisseurs, revendeurs et contacts.
- Notifications : GLPI prévient des contrats et licences proches de l'échéance, avant la reconduction automatique.
Ainsi, le coût fixe (abonnements et sièges) est dans GLPI, et le coût variable (tokens) se suit dans le tableau de bord du fournisseur ou de la plateforme utilisée. Ensemble, ils donnent le coût par ticket.
Téléchargez le calculateur
Nous avons préparé un tableur avec les prix mesurés. Vous indiquez combien de tickets vous avez par mois, la fréquence de chaque tâche et le modèle qui l'exécute, et il calcule le coût par ticket, par mois et par an :
Télécharger le calculateur du coût de l'IA par ticket (Excel, en anglais)
Conclusion
Le coût de l'IA par ticket est faible ; ce qui ne rentre pas dans le budget, c'est de ne pas le mesurer. Ventilez le coût par tâche, utilisez le bon modèle pour chacune, fixez des limites de dépense et traitez les abonnements d'IA comme des contrats et des licences dans GLPI. Avec ces quatre étapes, l'IA cesse d'être une ligne imprévisible sur la facture et devient un coût par ticket que vous pouvez expliquer à n'importe quel dirigeant.
Besoin d'aide pour intégrer l'IA à votre GLPI sans perdre le contrôle des coûts ? Parlez à l'équipe.
Test réalisé par l'équipe NexTool Solutions le 1er octobre 2026, avec des tickets fictifs et les prix publics d'OpenRouter à cette date. Modèles : openai/gpt-5.6-luna, google/gemini-3.5-flash-lite, anthropic/claude-sonnet-5.5 et typesafe/jev-1.13. Données du State of FinOps 2026 publiées par la FinOps Foundation.



