


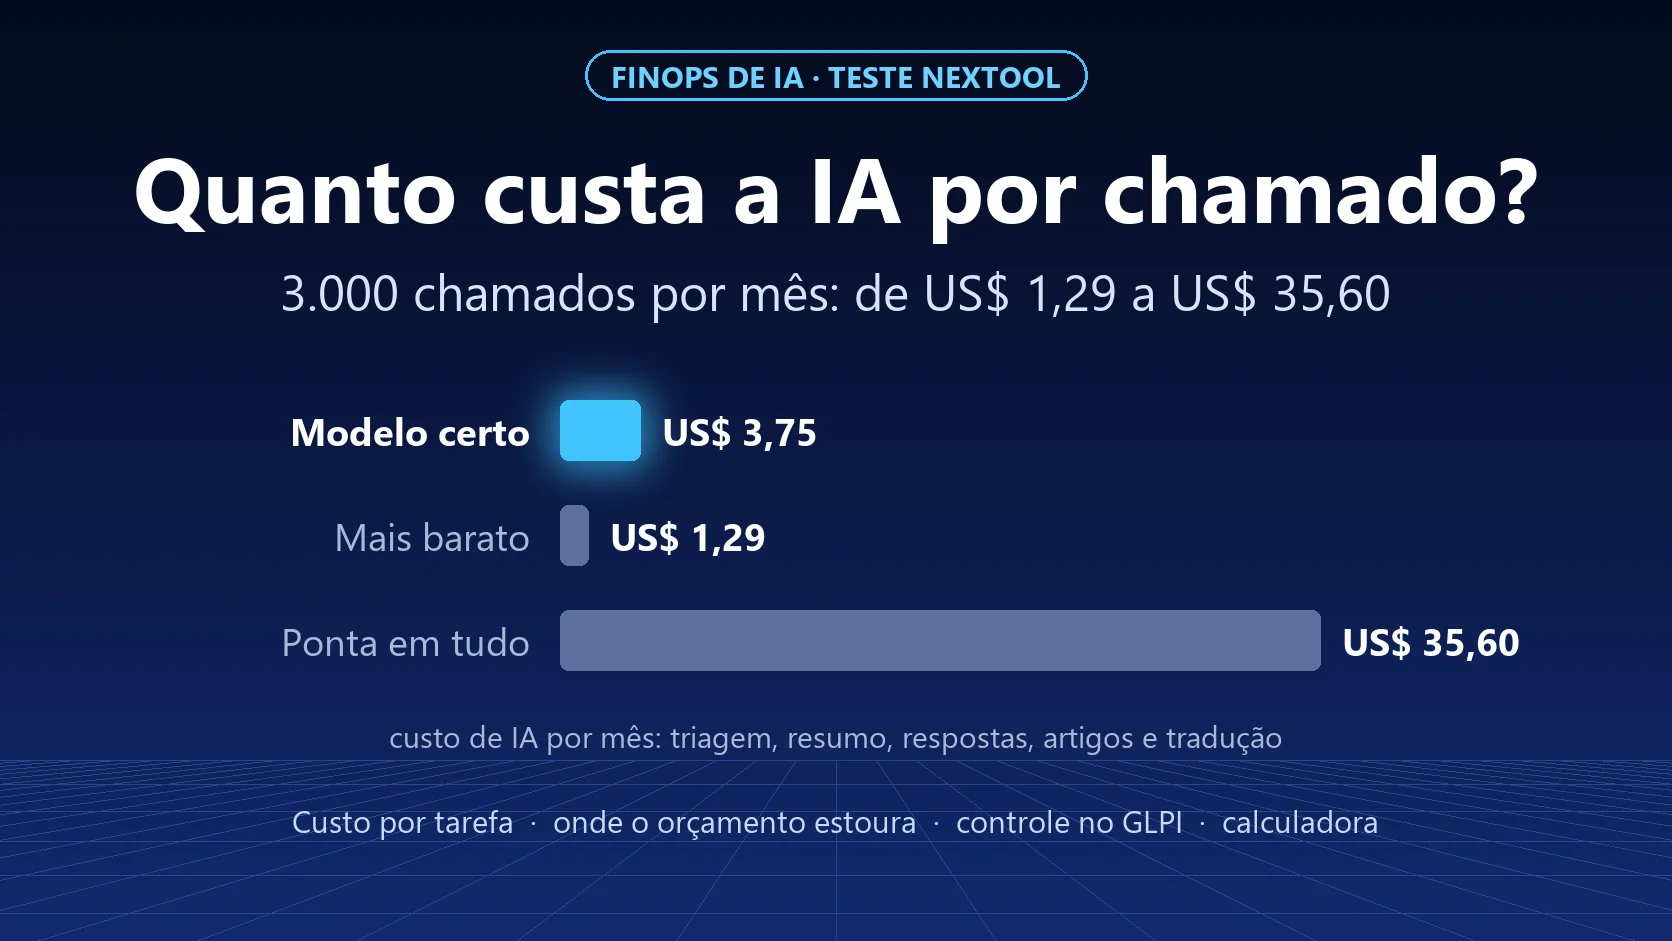
Poner IA en 3.000 tickets al mes costó entre US$ 1,29 y US$ 35,60 en nuestra prueba. La diferencia de casi 28 veces no vino de la calidad: vino solo de qué modelo hacía cada tarea. Y aun así, el 98% de los equipos de FinOps ya gestiona gasto en IA y la mayoría no consigue preverlo. El problema rara vez es el precio del token. Es no saber cuánto cuesta cada ticket.
Este artículo continúa Clasificación de tickets sin LLM: probamos Jev y medimos el costo por mil tickets, donde comparamos tres modelos en la clasificación de 200 tickets.
FinOps: de la nube a la IA
FinOps es la práctica de dar visibilidad y responsable al gasto en tecnología: quién gasta, cuánto, en qué y si vale lo que cuesta. Nació para la factura de la nube y ahora llegó a la IA. El informe State of FinOps 2026, de la FinOps Foundation, encuestó a 1.192 profesionales: el 98% ya gestiona gasto en IA, frente al 31% dos años antes. Análisis del mismo informe señalan que la mayoría de las empresas superó su previsión de costo de IA en el último año.
La causa casi siempre es la misma: la IA se cobra por uso (tokens), pero se planifica como si fuera una mensualidad. Nadie sabe decir cuánto cuesta resumir un ticket, y entonces nadie sabe decir cuánto costará el mes.
La cuenta que nadie hace: cuánto cuesta cada tarea
La medimos. Tomamos 10 tickets ficticios con historial completo (apertura, seguimientos y solución, de 4 a 8 mensajes cada uno) y pedimos cuatro tareas a tres modelos, vía OpenRouter, con precios de lista del 1 de octubre de 2026:
| Tarea (costo cada 1.000 usos) | GPT-5.6 Luna | Gemini 3.5 Flash-Lite | Claude Sonnet 5.5 |
|---|---|---|---|
| Resumir el historial | US$ 0,15 | US$ 0,29 | US$ 3,22 |
| Sugerir la próxima respuesta | US$ 0,11 | US$ 0,20 | US$ 2,95 |
| Generar artículo de base de conocimiento | US$ 0,34 | US$ 0,65 | US$ 8,54 |
| Traducir el último mensaje | US$ 0,10 | US$ 0,11 | US$ 1,30 |
Y, de la prueba anterior, la clasificación (categoría, tipo y urgencia): US$ 0,034 cada mil tickets con Jev, US$ 0,12 con GPT-5.6 Luna y US$ 1,83 con Claude Sonnet 5.5.
Dos detalles que la tabla esconde:
- El modelo de punta escribe más. En el artículo, Claude Sonnet 5.5 generó en promedio 789 tokens de respuesta, frente a 255 de GPT-5.6 Luna. La salida es la parte cara del token; un texto más largo cuesta más, aunque sea mejor.
- Se paga hasta la respuesta que no llega. En un ticket de ransomware, Sonnet usó los 300 tokens que liberamos para razonar y devolvió una respuesta vacía. La llamada se cobró igual.
Tres escenarios para 3.000 tickets al mes
Armamos una mesa de ayuda típica: cada ticket se clasifica, se resume el historial una vez y recibe dos sugerencias de respuesta; el 10% se convierte en artículo de base de conocimiento y el 5% necesita traducción.

| Escenario | Costo por ticket | Al mes (3.000 tickets) | Al año |
|---|---|---|---|
| Todo en el modelo de punta (Claude Sonnet 5.5) | US$ 0,0119 | US$ 35,60 | US$ 427 |
| El modelo correcto para cada tarea (Jev en la clasificación, GPT-5.6 Luna en el día a día, Sonnet solo en el artículo) | US$ 0,0013 | US$ 3,75 | US$ 45 |
| Todo en el modelo más barato (Jev + GPT-5.6 Luna) | US$ 0,0004 | US$ 1,29 | US$ 16 |
El escenario del medio es el que recomendamos: el modelo de punta queda solo donde la calidad de la redacción pesa (el artículo que va a la base) y el resto va a modelos rápidos y baratos. El costo baja 9,5 veces.
Fíjese en el orden de magnitud: incluso el escenario más caro cuesta centavos por ticket. Si la IA ahorra un minuto del analista en cada ticket, ya se paga con holgura.
Dónde se dispara de verdad el presupuesto de IA
Si el costo por ticket es tan bajo, ¿por qué tantas empresas superan el presupuesto? Porque la fuga rara vez está en el ticket:
- Licencias por usuario que nadie usa. Los asistentes de IA vendidos por asiento cobran cada mes, se usen o no. Es el mismo problema de licencias ociosas que FinOps ya conoce en la nube.
- Modelo de punta en todo. En nuestra prueba, eso multiplicó el costo por 9,5 sin ganancia en la clasificación.
- Demasiado contexto. Enviar el historial completo, adjuntos y firmas de correo a la IA en cada clic hace que el costo crezca con el tamaño del ticket, no con el valor de la tarea.
- Razonamiento sin límite. Los modelos que "piensan" antes de responder cobran ese pensamiento. Sin límite de tokens, una tarea simple puede costar como una compleja, o no entregar nada.
- Agentes en bucle. Un agente que intenta, falla y vuelve a intentar puede hacer cientos de llamadas sin que nadie lo vea.
- Uso subsidiado que va a terminar. Las suscripciones de IA hoy entregan mucho más de lo que cuestan. En NexTool, en 30 días de desarrollo, usamos unos 3.900 millones de tokens: aproximadamente R$ 15.000 a precio de lista, cubiertos por una suscripción de unos US$ 200. Quien planifique el futuro con el precio subsidiado se llevará una sorpresa cuando cambie.
Cómo medir sin complicarse
Cuatro números bastan para empezar:
- Costo de IA por ticket resuelto, separado por tarea (clasificación, resumen, respuesta, artículo).
- Tokens por tarea, para encontrar la tarea que envía demasiado contexto.
- Porcentaje de tickets con ayuda de la IA, para saber si el gasto acompaña el uso.
- Tiempo del analista ahorrado, aunque sea estimado, para comparar con el costo.
Y tres frenos simples:
- Límite de gasto por clave de API. En nuestra prueba usamos una clave con tope de US$ 10; si algo sale mal, el perjuicio tiene límite.
- Límite de tokens por tarea, con espacio suficiente para que el modelo responda (el caso del ransomware muestra lo que pasa cuando falta).
- Un modelo por tarea, configurado y revisado, en lugar de "el mejor modelo en todo".
Controlar el gasto en IA dentro de GLPI
GLPI ya tiene lo necesario para tratar la IA como cualquier otro costo de TI, sin herramienta nueva:
- Contratos: registre el contrato con cada proveedor de IA, con valor, período, renovación y aviso de vencimiento.
- Licencias: registre los asientos de asistentes de IA como licencias, con cantidad y a quién están asignados. Una licencia sin usuario aparece de inmediato.
- Presupuestos: cree un presupuesto de IA por entidad o área y vincule los contratos.
- Proveedores: centralice proveedores, revendedores y contactos.
- Notificaciones: GLPI avisa de contratos y licencias próximos a vencer, antes de la renovación automática.
Así, el costo fijo (suscripciones y asientos) queda en GLPI, y el costo variable (tokens) lo sigue en el panel del proveedor o de la plataforma que use. Juntos, dan el costo por ticket.
Descargue la calculadora
Preparamos una planilla con los precios que medimos. Usted indica cuántos tickets tiene al mes, cuántas veces ocurre cada tarea y qué modelo hace cada una, y calcula el costo por ticket, por mes y por año:
Descargar la calculadora de costo de IA por ticket (Excel, en inglés)
Conclusión
El costo de IA por ticket es pequeño; lo que no cabe en el presupuesto es no medirlo. Separe el costo por tarea, use el modelo correcto para cada una, ponga límite de gasto y trate las suscripciones de IA como contrato y licencia dentro de GLPI. Con estos cuatro pasos, la IA deja de ser una línea impredecible en la factura y pasa a ser un costo por ticket que usted explica a cualquier director.
¿Quiere ayuda para llevar IA a su GLPI sin perder el control del costo? Hable con el equipo.
Prueba realizada por el equipo de NexTool Solutions el 1 de octubre de 2026, con tickets ficticios y precios de lista de OpenRouter en esa fecha. Modelos: openai/gpt-5.6-luna, google/gemini-3.5-flash-lite, anthropic/claude-sonnet-5.5 y typesafe/jev-1.13. Datos del State of FinOps 2026 publicados por la FinOps Foundation.



