


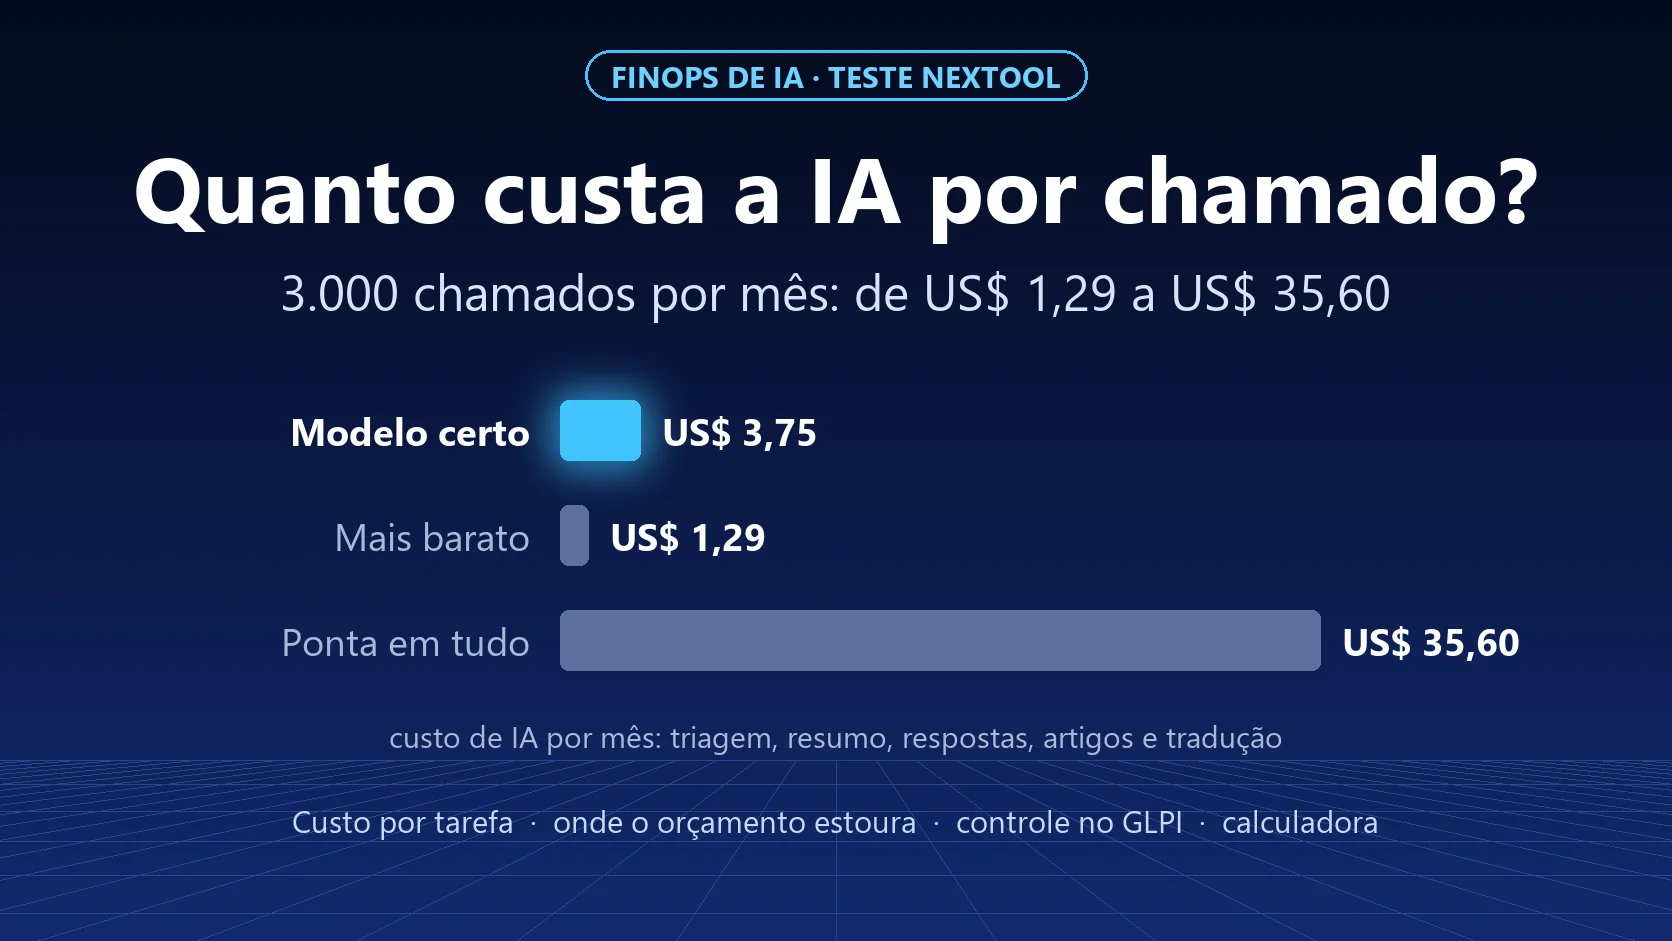
Pôr IA em 3.000 pedidos por mês custou entre 1,29 US$ e 35,60 US$ no nosso teste. A diferença de quase 28 vezes não veio da qualidade: veio apenas de qual modelo fazia cada tarefa. E, mesmo assim, 98% das equipas de FinOps já gerem despesa com IA e a maioria não consegue prevê-la. O problema raramente é o preço do token. É não saber quanto custa cada pedido.
Este artigo continua Triagem de pedidos sem LLM: testámos o Jev e medimos o custo por mil pedidos, onde comparámos três modelos na triagem de 200 pedidos.
FinOps: da cloud à IA
FinOps é a prática de dar visibilidade e um responsável à despesa com tecnologia: quem gasta, quanto, em quê e se vale o que custa. Nasceu para a fatura da cloud e chegou agora à IA. O relatório State of FinOps 2026, da FinOps Foundation, inquiriu 1.192 profissionais: 98% já gerem despesa com IA, contra 31% dois anos antes. Análises do mesmo relatório indicam que a maioria das empresas ultrapassou a previsão de custo com IA no último ano.
A causa é quase sempre a mesma: a IA é cobrada por utilização (tokens), mas é planeada como se fosse uma mensalidade. Ninguém sabe dizer quanto custa resumir um pedido e, por isso, ninguém sabe dizer quanto vai custar o mês.
A conta que ninguém faz: quanto custa cada tarefa
Medimos. Pegámos em 10 pedidos fictícios com histórico completo (abertura, acompanhamentos e solução, de 4 a 8 mensagens cada) e pedimos quatro tarefas a três modelos, através do OpenRouter, com preços de tabela de 1 de outubro de 2026:
| Tarefa (custo por cada 1.000 utilizações) | GPT-5.6 Luna | Gemini 3.5 Flash-Lite | Claude Sonnet 5.5 |
|---|---|---|---|
| Resumir o histórico | 0,15 US$ | 0,29 US$ | 3,22 US$ |
| Sugerir a próxima resposta | 0,11 US$ | 0,20 US$ | 2,95 US$ |
| Gerar artigo da base de conhecimento | 0,34 US$ | 0,65 US$ | 8,54 US$ |
| Traduzir a última mensagem | 0,10 US$ | 0,11 US$ | 1,30 US$ |
E, do teste anterior, a triagem (categoria, tipo e urgência): 0,034 US$ por cada mil pedidos com o Jev, 0,12 US$ com o GPT-5.6 Luna e 1,83 US$ com o Claude Sonnet 5.5.
Dois detalhes que a tabela esconde:
- O modelo de topo escreve mais. No artigo, o Claude Sonnet 5.5 gerou em média 789 tokens de resposta, contra 255 do GPT-5.6 Luna. A saída é a parte cara do token; um texto mais longo custa mais, mesmo quando é melhor.
- Paga-se até a resposta que não chega. Num pedido de ransomware, o Sonnet usou os 300 tokens que libertámos para raciocinar e devolveu uma resposta vazia. A chamada foi cobrada na mesma.
Três cenários para 3.000 pedidos por mês
Montámos um centro de serviços típico: cada pedido é triado, tem o histórico resumido uma vez e recebe duas sugestões de resposta; 10% dão origem a um artigo da base de conhecimento e 5% precisam de tradução.

| Cenário | Custo por pedido | Por mês (3.000 pedidos) | Por ano |
|---|---|---|---|
| Tudo no modelo de topo (Claude Sonnet 5.5) | 0,0119 US$ | 35,60 US$ | 427 US$ |
| O modelo certo para cada tarefa (Jev na triagem, GPT-5.6 Luna no dia a dia, Sonnet só no artigo) | 0,0013 US$ | 3,75 US$ | 45 US$ |
| Tudo no modelo mais barato (Jev + GPT-5.6 Luna) | 0,0004 US$ | 1,29 US$ | 16 US$ |
O cenário do meio é o que recomendamos: o modelo de topo fica apenas onde a qualidade da escrita pesa (o artigo que vai para a base) e o resto vai para modelos rápidos e baratos. O custo cai 9,5 vezes.
Repare na ordem de grandeza: mesmo o cenário mais caro custa cêntimos por pedido. Se a IA poupar um minuto ao técnico em cada pedido, paga-se com folga.
Onde o orçamento de IA rebenta de verdade
Se o custo por pedido é tão baixo, porque é que tantas empresas ultrapassam o orçamento? Porque a fuga raramente está no pedido:
- Licenças por utilizador que ninguém usa. Os assistentes de IA vendidos por posto cobram todos os meses, usados ou não. É o mesmo problema de licenças paradas que o FinOps já conhece na cloud.
- Modelo de topo em tudo. No nosso teste, isso multiplicou o custo por 9,5 sem ganho na triagem.
- Contexto a mais. Enviar o histórico completo, anexos e assinaturas de e-mail à IA a cada clique faz o custo crescer com o tamanho do pedido, não com o valor da tarefa.
- Raciocínio sem limite. Os modelos que "pensam" antes de responder cobram esse pensamento. Sem limite de tokens, uma tarefa simples pode custar tanto como uma complexa, ou não entregar nada.
- Agentes em ciclo. Um agente que tenta, falha e volta a tentar pode fazer centenas de chamadas sem ninguém ver.
- Utilização subsidiada que vai acabar. As subscrições de IA entregam hoje muito mais do que custam. Na NexTool, em 30 dias de desenvolvimento, usámos cerca de 3,9 mil milhões de tokens: aproximadamente 15 mil reais a preço de tabela, cobertos por uma subscrição de cerca de 200 US$. Quem planear o futuro com base no preço subsidiado vai apanhar um susto quando ele mudar.
Como medir sem complicar
Quatro números chegam para começar:
- Custo de IA por pedido resolvido, separado por tarefa (triagem, resumo, resposta, artigo).
- Tokens por tarefa, para encontrar a tarefa que envia contexto a mais.
- Percentagem de pedidos com ajuda da IA, para saber se a despesa acompanha a utilização.
- Tempo do técnico poupado, mesmo que estimado, para comparar com o custo.
E três travões simples:
- Limite de despesa por chave de API. No nosso teste usámos uma chave com teto de 10 US$; se algo correr mal, o prejuízo tem limite.
- Limite de tokens por tarefa, com espaço suficiente para o modelo responder (o caso do ransomware mostra o que acontece quando falta).
- Um modelo por tarefa, configurado e revisto, em vez de "o melhor modelo em tudo".
Controlar a despesa de IA dentro do GLPI
O GLPI já tem o necessário para tratar a IA como qualquer outro custo de TI, sem ferramenta nova:
- Contratos: registe o contrato com cada fornecedor de IA, com valor, período, renovação e aviso de fim.
- Licenças: registe os postos de assistentes de IA como licenças, com quantidade e a quem estão atribuídos. Uma licença sem utilizador aparece logo.
- Orçamentos: crie um orçamento de IA por entidade ou área e associe-lhe os contratos.
- Fornecedores: centralize fornecedores, revendedores e contactos.
- Notificações: o GLPI avisa de contratos e licenças perto do fim, antes da renovação automática.
Assim, o custo fixo (subscrições e postos) fica no GLPI, e o custo variável (tokens) acompanha-se no painel do fornecedor ou da plataforma que usa. Juntos, dão o custo por pedido.
Descarregue a calculadora
Preparámos uma folha de cálculo com os preços que medimos. Indica quantos pedidos tem por mês, quantas vezes acontece cada tarefa e que modelo faz cada uma, e ela calcula o custo por pedido, por mês e por ano:
Descarregar a calculadora de custo de IA por pedido (Excel)
Conclusão
O custo de IA por pedido é pequeno; o que não cabe no orçamento é não o medir. Separe o custo por tarefa, use o modelo certo para cada uma, ponha limite de despesa e trate as subscrições de IA como contrato e licença dentro do GLPI. Com estes quatro passos, a IA deixa de ser uma linha imprevisível na fatura e passa a ser um custo por pedido que explica a qualquer diretor.
Quer ajuda para pôr IA no seu GLPI sem perder o controlo do custo? Fale com a equipa.
Teste realizado pela equipa NexTool Solutions a 1 de outubro de 2026, com pedidos fictícios e preços de tabela do OpenRouter nessa data. Modelos: openai/gpt-5.6-luna, google/gemini-3.5-flash-lite, anthropic/claude-sonnet-5.5 e typesafe/jev-1.13. Dados do State of FinOps 2026 publicados pela FinOps Foundation.



