Störungsmanagement ist die ITSM-Praxis, die die meisten zu beherrschen glauben, und diejenige, die im realen Betrieb am häufigsten versagt. Beim Betrieb von GLPI-Umgebungen unserer Kunden liegt das Problem fast nie darin, dass der Techniker nicht weiß, wie man ein Ticket schließt - sondern im SLA, das überschritten wird, ohne dass jemand benachrichtigt wird, in der Priorität, die jemand von Hand geändert hat, und im Cron, der im falschen Modus läuft. Dieser Leitfaden zeigt, wo die Störung im GLPI liegt, wie Sie klassifizieren, ohne Felder zu erfinden, und welche Fallstricke aus der Praxis erst nach Monaten im Betrieb auftauchen.
Wo die Störung im GLPI liegt
Störung und Anfrage sind keine getrennten Module: Sie sind dasselbe Objekt Ticket in der Tabelle glpi_tickets, unterschieden durch die Spalte type - 1 für Störung, 2 für Anfrage. Was sich ändert, sind der Ablauf, das SLA und die Auswertung für das Management. Laut ITIL 4 ist eine Störung eine ungeplante Unterbrechung oder eine Verschlechterung der Qualität eines Service, und das Ziel ist, den Service so schnell wie möglich wiederherzustellen, nicht die Ursache zu finden - das ist Aufgabe des Problemmanagements.
Jede Störung durchläuft eine feste Zustandsmaschine. Den Code jedes Status zu kennen ist wichtig, weil Berichte, Geschäftsregeln und Diagnose-SQL mit der Zahl arbeiten, nicht mit der Bezeichnung:
| Code | Status | Bedeutung | Verwendung im Betrieb |
|---|---|---|---|
| 1 | Neu | Erfasst, ohne Zuweisung | Triage-Warteschlange |
| 2 | In Bearbeitung (zugewiesen) | Techniker zugewiesen | Markiert das erfüllte TTO |
| 3 | In Bearbeitung (geplant) | Es gibt eine geplante Aufgabe | Eingeplante Arbeit |
| 4 | Wartend | Wartet auf Dritte oder den Anforderer | Kann die SLA-Uhr anhalten |
| 5 | Gelöst | Workaround oder Korrektur angewendet | Öffnet das Fenster für das automatische Schließen |
| 6 | Geschlossen | Vom Anforderer bestätigt | Löst die Zufriedenheitsumfrage aus |
Das Detail, an dem Berichte scheitern: Der Status Wartend (4) hält die SLA-Zählung an, wenn Sie es so konfigurieren. Ein Techniker, der alles auf Wartend setzt, um „die Frist nicht zu überschreiten“, verschleiert die Kennzahl, statt den Support zu verbessern.
Klassifizierung: die Matrix Dringlichkeit × Auswirkung
GLPI lässt den Techniker die Priorität nicht einfach frei wählen. Sie wird aus der Kombination zweier Felder berechnet, die Anforderer und Triage-Mitarbeiter angeben: Dringlichkeit (wie schnell das Geschäft es braucht) und Auswirkung (wie viele betroffen sind und wie kritisch). Die Matrix befindet sich unter Einstellungen > Allgemein > Unterstützung und ist vollständig bearbeitbar. Ein vereinfachter Ausschnitt der Logik:
| Dringlichkeit \ Auswirkung | Niedrig | Mittel | Hoch |
|---|---|---|---|
| Hoch | Mittel | Hoch | Sehr hoch |
| Mittel | Niedrig | Mittel | Hoch |
| Niedrig | Sehr niedrig | Niedrig | Mittel |
GLPI unterstützt bis zu fünf Stufen für Dringlichkeit und Auswirkung, plus die Priorität Major (kritisch). Die Standardmatrix ist symmetrisch - Dringlichkeit und Auswirkung wiegen gleich. Passen Sie die Gewichtung an die Realität des Kunden an: Im Einzelhandel ist ein ausgefallenes Kassensystem zur Hauptverkaufszeit höchste Dringlichkeit, unabhängig von der Anzahl der betroffenen Filialen.
Der Bearbeitungsablauf Schritt für Schritt
- Erfassung: Self-Service-Portal, E-Mail (Collector), Telefon oder Integration. Geschäftsregeln (
RuleTicket) klassifizieren Kategorie, Gruppe und Priorität automatisch beimitem_add. - Take into account (erste Reaktion): GLPI speichert in
takeintoaccount_delay_statdie Zeit bis zur ersten Aktion des Technikers. Das ist Ihr Reaktions-SLA (TTO - time to own), anders als das Lösungs-SLA (TTR - time to resolve). - Untersuchung: Wissensdatenbank, Verlauf ähnlicher Tickets und CMDB. Das Modul AI Assist fasst lange Verläufe zusammen und schlägt Lösungen auf Basis der Wissensdatenbank vor.
- Lösung: endgültig (Ursache behoben) oder Workaround. Handelt es sich um einen wiederkehrenden Workaround, verknüpfen Sie ihn mit einem Problem - die Störung „wird“ nicht zum Problem, es sind unterschiedliche Objekte.
- Abschluss: Nach der Bestätigung geht das Ticket auf Geschlossen und löst die Zufriedenheitsumfrage aus.
Fallstrick Nr. 1 im Betrieb: Cron im falschen Modus
Das ist der Fehler, den wir bei neuen Kundenumgebungen am häufigsten beheben. Das SLA ist konfiguriert, die Eskalationsstufen sind angelegt, und trotzdem erhält niemand eine Warnung, wenn die Frist überschritten wird, und gelöste Tickets werden nie automatisch geschlossen. Die Ursache ist fast immer dieselbe: Die automatischen Aktionen des GLPI laufen im Modus GLPI (Web), der nur ausgeführt wird, wenn jemand eine Seite lädt. Bei einem Kunden mit wenig Verkehr außerhalb der Geschäftszeiten läuft die SLA-Eskalation schlicht nicht.
Die Korrektur besteht darin, den Scheduler in den CLI-Modus zu versetzen und über einen Cron des Betriebssystems auszulösen. Setzen Sie bei jeder automatischen Aktion (Einstellungen > Automatische Aktionen) Ausführungsmodus = CLI und fügen Sie den Eintrag in die crontab ein:
# /etc/cron.d/glpi - executa o agendador do GLPI a cada minuto
# GLPI 10 e 11: front/cron.php e o caminho portavel entre versoes
* * * * * www-data /usr/bin/php /var/www/glpi/front/cron.php >/dev/null 2>&1
Von diesem Cron hängen ab: closeticket (schließt automatisch, was länger als die Frist auf Gelöst stand), createinquest (erzeugt die Zufriedenheitsumfrage) und die Eskalation nach SLA-Stufe. Ein Portabilitätsdetail, über das viele stolpern: In GLPI 11 gibt es den Konsolenbefehl glpi:cron nicht, den einige Tutorials für GLPI 10 erwähnen - der Weg, der in beiden Versionen funktioniert, ist das oben gezeigte front/cron.php.
Diagnose: Störungen mit überschrittenem SLA finden
Wenn der Kunde sagt „das SLA wird nicht eingehalten“, ist der erste Schritt, die Rohdaten anzusehen, nicht das Dashboard. Dieses SQL listet offene Störungen, deren Lösungsfrist bereits abgelaufen ist, und markiert diejenigen, die nie auch nur zur Kenntnis genommen wurden (takeintoaccount_delay_stat = 0):
SELECT t.id,
       t.name AS titulo,
       c.completename AS categoria,
       t.priority,
       t.time_to_resolve,
       IF(t.takeintoaccount_delay_stat = 0,
          'SEM PRIMEIRA RESPOSTA', 'ok') AS atendimento
FROM glpi_tickets t
LEFT JOIN glpi_itilcategories c ON c.id = t.itilcategories_id
WHERE t.is_deleted = 0
  AND t.type = 1                       -- 1 = incidente
  AND t.status NOT IN (5, 6)           -- exclui Solucionado e Fechado
  AND t.time_to_resolve IS NOT NULL
  AND t.time_to_resolve < NOW()        -- prazo de resolucao ja estourou
  AND t.solvedate IS NULL
ORDER BY t.time_to_resolve ASC;
Wenn wir das im Betrieb ausführen, ist das häufigste Muster kein hohes Ticketvolumen: Es ist eine Handvoll Störungen mit hoher Priorität, die seit Tagen auf Wartend stehen, mit „angehaltener“ Uhr, während der Anforderer glaubt, dass sie bearbeitet werden.
Eskalationsbenachrichtigung, die die Führungskraft liest
Die Standardvorlage für Eskalationen verschickt einen generischen Block. Eine schlanke Vorlage mit den richtigen Tags bringt den Supervisor zum Handeln, ohne dass er GLPI öffnen muss. Die Tags ##ticket.*## werden von GLPI beim Versand aufgelöst:
Assunto: [SLA estourado] Chamado ##ticket.id## - ##ticket.title##

O chamado abaixo ultrapassou o prazo de resolucao.

Titulo:      ##ticket.title##
Categoria:   ##ticket.category##
Prioridade:  ##ticket.priority##
Status:      ##ticket.status##
Atribuido a: ##ticket.assigntousers##
Prazo (TTR): ##ticket.time_to_resolve##

Abrir o chamado: ##ticket.url##
Häufige Fehler in der Praxis
- „Alles ist dringend“: Wenn jedes Ticket mit hoher Priorität eingeht, haben Sie keine Priorisierung, sondern eine teure chronologische Warteschlange. Sperren Sie die Dringlichkeit im geführten Formular und schulen Sie anhand der Matrix.
- Von Hand bearbeitete Priorität: Ein Techniker, der die berechnete Priorität überschreibt, verfälscht die SLA-Auswertung und die Matrix. Wenn ständig neu klassifiziert werden muss, liegt der Fehler in der Matrix, nicht beim Techniker.
- TTO mit TTR verwechseln: „Ich habe das Ticket zum Lesen geöffnet“ zählt bereits als take into account und erfüllt das Reaktions-SLA, ohne dass irgendetwas gelöst wurde. Messen Sie das TTR (Lösung), nicht nur das TTO.
- Workaround, der zur Dauerlösung wird: Workaround angewendet und Ticket geschlossen, ohne ein Problem zu erstellen - die Störung kommt in der folgenden Woche zurück. Verknüpfen Sie wiederkehrende Workarounds mit einem Problem.
Nächster Schritt
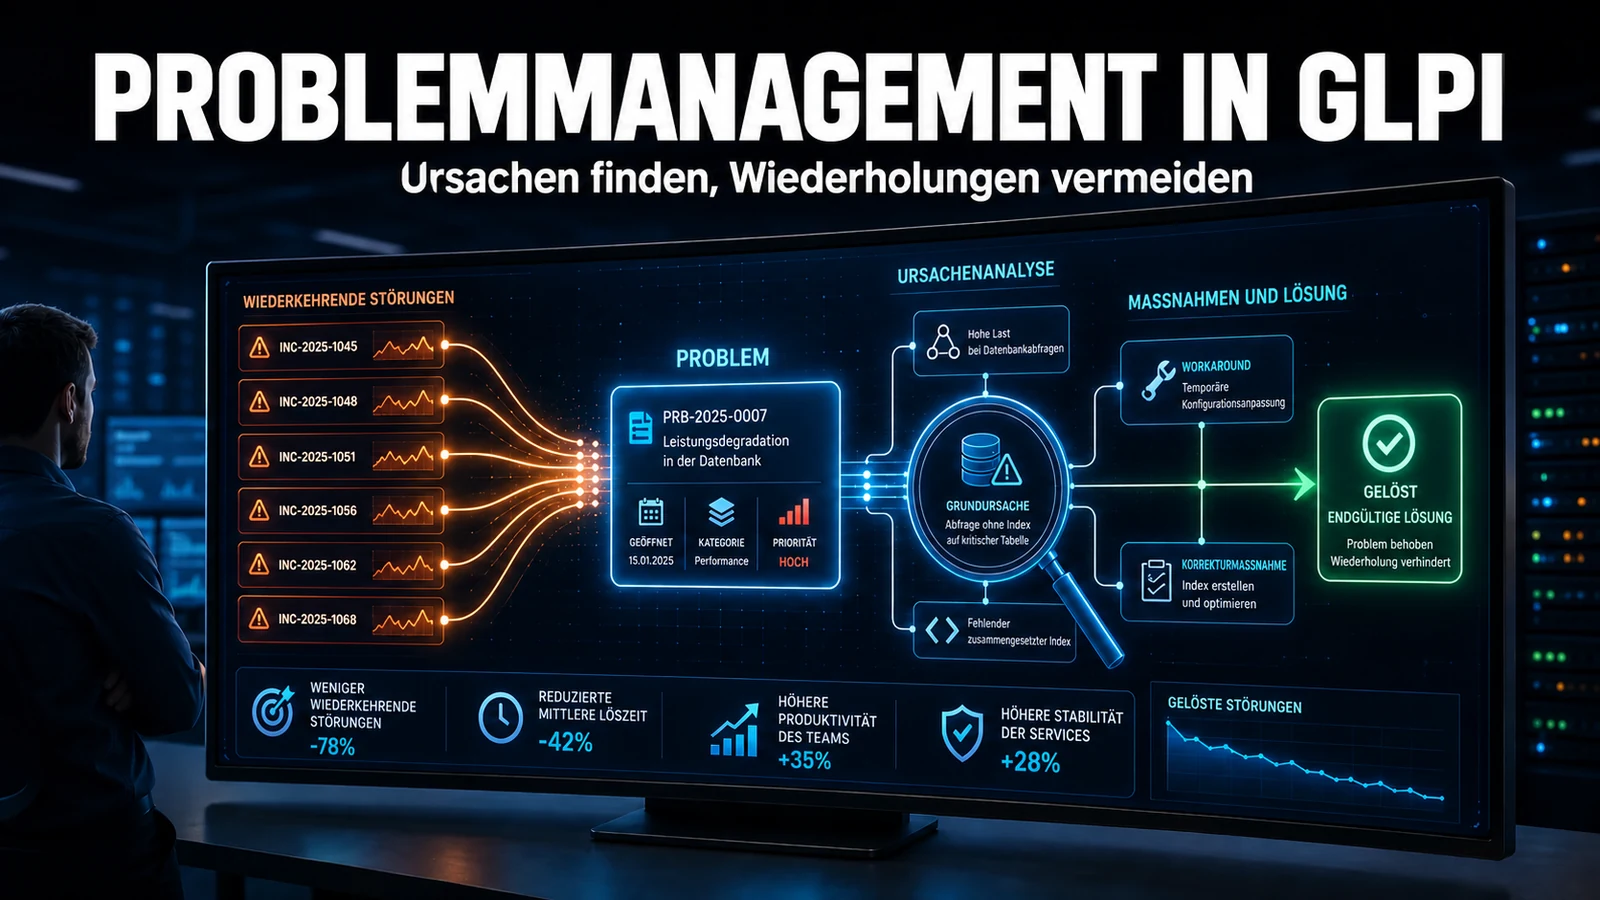
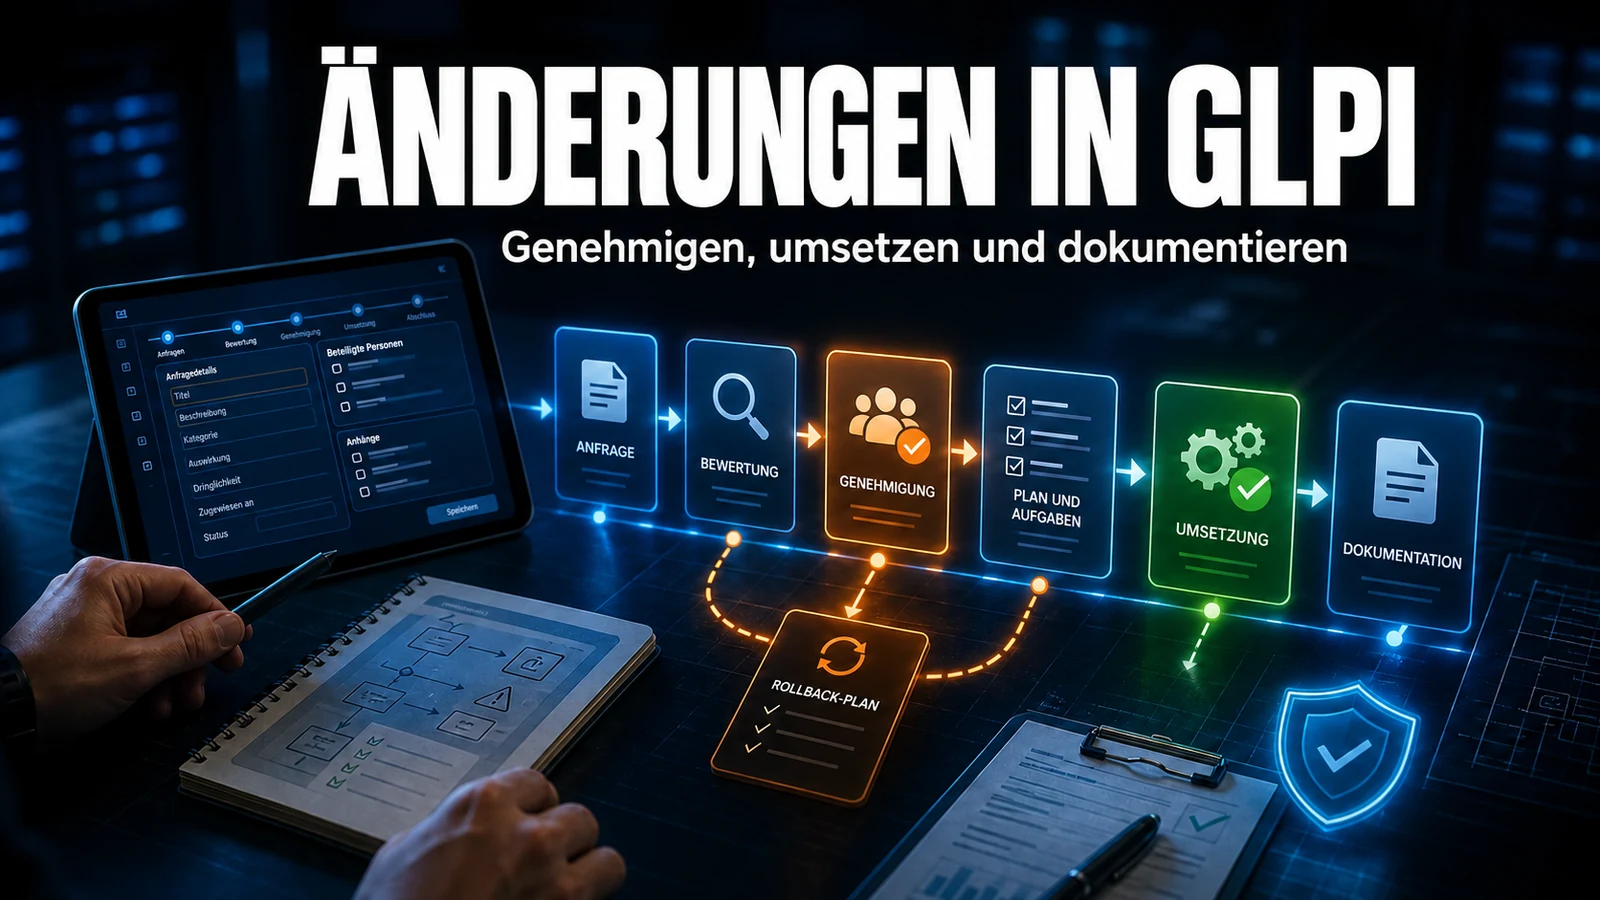
Wenn das Störungsmanagement rund läuft, gehen Sie weiter zum Problemmanagement (Grundursache beseitigen) und zum Änderungsmanagement. Um die Triage zu beschleunigen, verteilt das Modul Smart Assign Störungen nach Auslastungs- und Kompetenzregeln auf die Techniker, und der Leitfaden zu SLA und OLA behandelt die Konfiguration der Fristen.
Sie brauchen ein GLPI, das das SLA wirklich hält? NexTool betreibt GLPI-Umgebungen von Anfang bis Ende - von der Prioritätsmatrix bis zum Eskalations-Cron. Lernen Sie den Support- und Betriebsservice kennen.
Geprüft vom Team von NexTool Solutions.