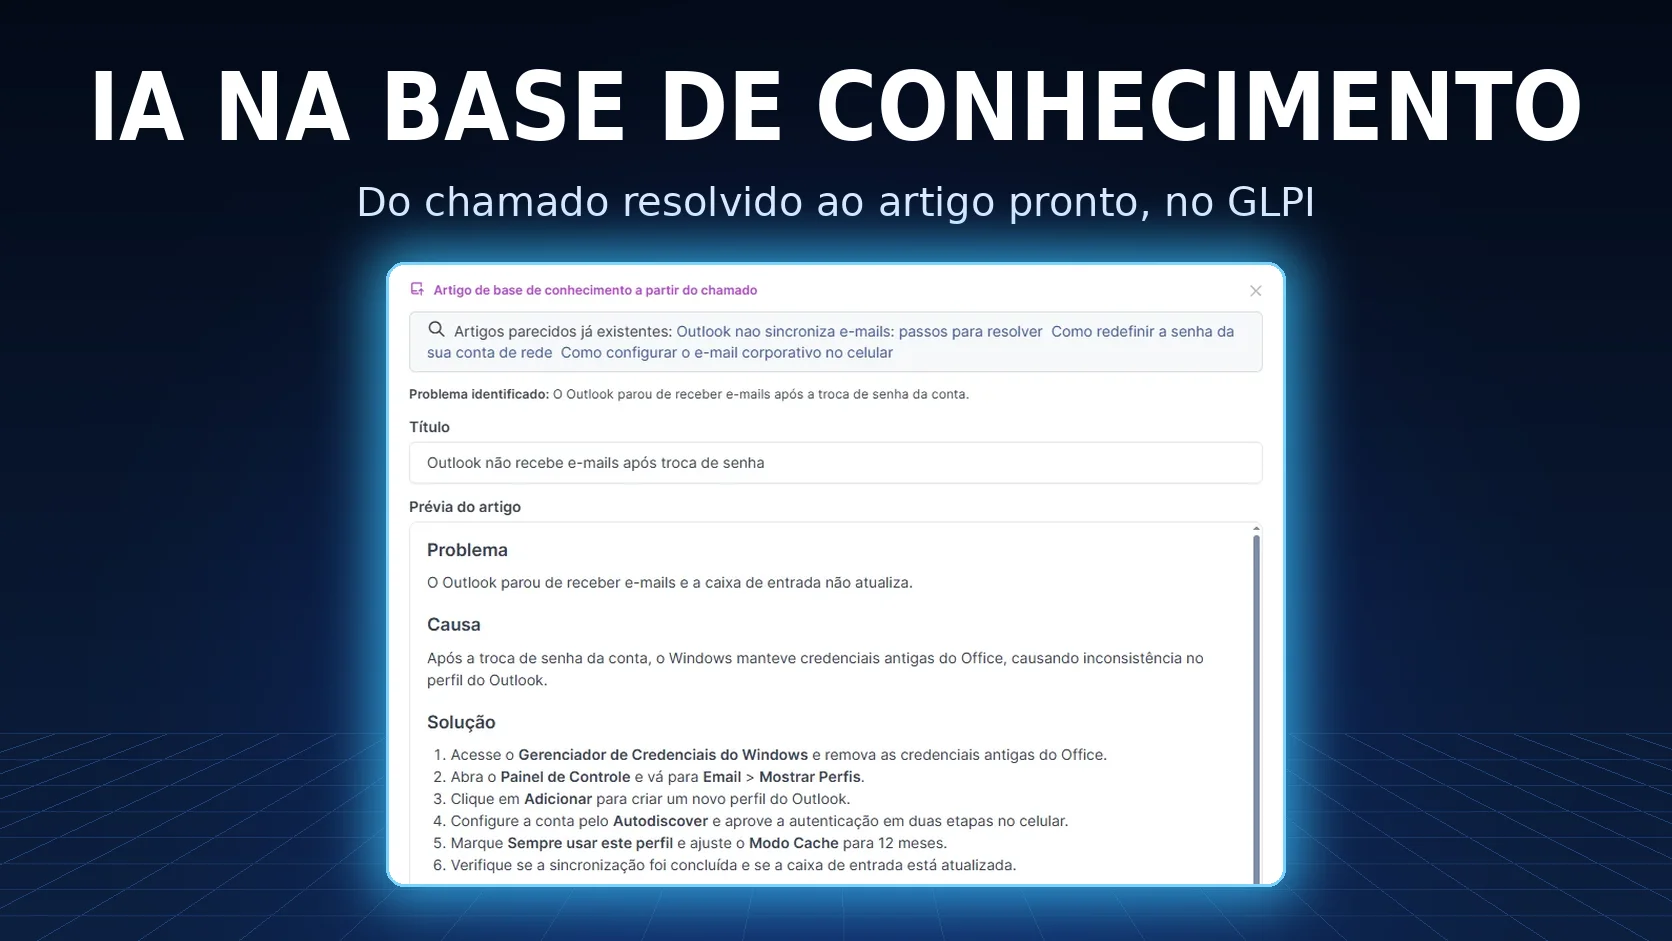
O conhecimento que vive na cabeça de um técnico morre quando ele sai - mas uma base de conhecimento mal configurada é pior: parece documentação e devolve zero resultados. Na sustentação de parques GLPI para clientes, os dois fracassos que mais vemos são artigos que ninguém encontra (problema de configuração) e artigos que ninguém escreve (problema de envolvimento). Este guia trata os dois, com as consultas e os ajustes que executamos no terreno.
Estruture a taxonomia antes do primeiro artigo
A base de conhecimento do GLPI é nativa (tabela glpi_knowbaseitems) e já traz categorias, FAQ, pesquisa full-text, controlo de visibilidade, histórico de revisões e ligação a chamados. O erro comum é começar pelos artigos e deixar a árvore de categorias crescer sozinha: em seis meses tem doze níveis e ninguém encontra nada. Fixe a estrutura primeiro:
- No máximo dois níveis de categoria. Se precisa de um terceiro, provavelmente é uma etiqueta, não uma categoria.
- Títulos acionáveis: "Como repor a palavra-passe no AD" funciona melhor que "Active Directory". O utilizador procura pela ação, não pelo sistema.
- Quatro famílias cobrem 90% dos casos: Como fazer (tutoriais), Resolução de problemas (erros conhecidos), Políticas (regras) e FAQ (pública).
- Um artigo pode estar em várias categorias no GLPI 10/11 (tabela glpi_knowbaseitems_knowbaseitemcategories). Use com parcimónia: categorias a mais equivalem a nenhuma.
O erro que faz os artigos "desaparecerem": a visibilidade
Na sustentação, a falha número 1 que encontramos não é a falta de artigo - é um artigo publicado que ninguém vê. O técnico escreve-o, guarda-o, marca-o como publicado e assume que está no ar. Mas a visibilidade do GLPI funciona por alvo explícito: se ninguém adicionou um perfil, grupo, entidade ou utilizador no separador de destinatários, o artigo fica visível apenas para o autor - e o GLPI não emite qualquer aviso. Já auditámos bases com centenas de artigos onde dezenas estavam nesse limbo. Por isso, no onboarding de sustentação, a primeira coisa que executamos é a consulta de artigos órfãos de visibilidade, antes de falar de taxonomia ou de envolvimento:
-- Artigos NAO-FAQ sem qualquer alvo de visibilidade:
-- existem, contam no total e sao invisiveis para todos, menos o autor.
SELECT k.id, k.name
FROM glpi_knowbaseitems k
LEFT JOIN glpi_knowbaseitems_profiles p ON p.knowbaseitems_id = k.id
LEFT JOIN glpi_knowbaseitems_users    u ON u.knowbaseitems_id = k.id
LEFT JOIN glpi_groups_knowbaseitems   g ON g.knowbaseitems_id = k.id
LEFT JOIN glpi_entities_knowbaseitems e ON e.knowbaseitems_id = k.id
WHERE k.is_faq = 0
  AND p.knowbaseitems_id IS NULL
  AND u.knowbaseitems_id IS NULL
  AND g.knowbaseitems_id IS NULL
  AND e.knowbaseitems_id IS NULL;
Um detalhe que só morde quem escreve esta consulta: os nomes das quatro tabelas de visibilidade não são simétricos. Utilizadores e perfis usam glpi_knowbaseitems_users e glpi_knowbaseitems_profiles, mas grupos e entidades invertem para glpi_groups_knowbaseitems e glpi_entities_knowbaseitems. Trocar a ordem é passar horas a depurar um LEFT JOIN que nunca encaixa.
Porque é que "AD", "VM" e "PC" não devolvem nada na pesquisa
A pesquisa da base não é um LIKE: o GLPI monta um MATCH(name, answer) AGAINST(... IN BOOLEAN MODE) sobre o índice FULLTEXT da tabela. No MariaDB/MySQL com InnoDB (predefinição no GLPI 10 e 11), o parâmetro innodb_ft_min_token_size define o tamanho mínimo de palavra indexada, e a predefinição é 3. Consequência: as siglas de duas letras - "AD", "VM", "PC", "TI", "BD" - não entram no índice, e procurá-las devolve vazio mesmo havendo dezenas de artigos que as citam. É o motivo número 1 do "a pesquisa da base não presta" que ouvimos dos clientes. Diagnóstico:
SHOW VARIABLES LIKE 'innodb_ft_min_token_size';Baixe o limite para 2 no ficheiro de configuração do MariaDB e reinicie o serviço:
# /etc/mysql/mariadb.conf.d/50-server.cnf  (MariaDB)
[mysqld]
innodb_ft_min_token_size = 2
A parte que quase toda a gente esquece: mudar a variável não reindexar os artigos existentes. O token size é gravado na criação do índice, por isso tem de o reconstruir. A forma mais direta é forçar a reconstrução da tabela:
-- Reinicie o MariaDB e reconstrua o indice FULLTEXT
-- (o novo token size so vale apos recriar o indice):
ALTER TABLE glpi_knowbaseitems ENGINE=InnoDB;
O erro comum é baixar o token para 2, reiniciar e cantar vitória - a variável muda, mas o índice antigo continua a ignorar as siglas até à reconstrução. Em instalações antigas em MyISAM, o parâmetro equivalente é ft_min_word_len.
Janela de validade: o artigo que só aparece amanhã
Outra armadilha silenciosa são os campos begin_date e end_date do artigo. O GLPI filtra da pesquisa qualquer artigo cujo begin_date esteja no futuro ou cujo end_date já tenha passado. É útil para publicar um procedimento só a partir de uma data - mas também é a causa clássica de "criei o artigo e ele não aparece": alguém preencheu uma data de início sem querer. Se um artigo recém-criado não surge na pesquisa e a visibilidade está correta, verifique a janela de validade antes de tudo o resto.
FAQ pública para self-service
Para um artigo aparecer no portal do utilizador final, marque-o como FAQ (campo is_faq) e defina a visibilidade por entidade com a opção recursiva ligada, para propagar às subentidades. Se quiser a FAQ acessível sem sessão iniciada, ative a FAQ para utilizadores anónimos na configuração de Assistência do GLPI. A matriz que usamos para decidir onde cada artigo vive:
| Objetivo | is_faq | Alvo de visibilidade | Onde aparece |
|---|---|---|---|
| FAQ pública (self-service) | 1 | Entidade + recursivo | Portal do utilizador; sem sessão se a FAQ anónima estiver ligada |
| Base técnica interna | 0 | Perfil (ex.: Técnico) | Separador Base de conhecimento, só perfis com direito |
| Procedimento por cliente | 0 | Entidade específica | Só técnicos dessa entidade |
| Rascunho / em revisão | 0 | Nenhum (só o autor) | Invisível - use por intenção, nunca por esquecimento |
Repare na última linha: "nenhum alvo" é um estado válido para rascunho, mas deve ser uma escolha consciente, nunca o resultado de esquecer de preencher a visibilidade.
Envolvimento: o KPI que funciona (e o que não funciona)
O KPI de "X artigos por técnico por mês" que a literatura de ITSM adora produz lixo: artigos escritos para bater a meta, que ninguém consulta. O que funciona na prática é ligar a criação ao trabalho que já acontece - o fecho de chamado de categoria recorrente. Em vez de exigir volume, identifique o repetitivo e transforme-o em artigo. Esta consulta lista os assuntos que mais se repetiram nos últimos 90 dias, os candidatos de maior retorno:
-- Assuntos de chamado repetidos nos ultimos 90 dias:
-- os candidatos de maior retorno para virarem artigos da base.
SELECT t.name AS assunto, COUNT(*) AS total
FROM glpi_tickets t
WHERE t.date >= DATE_SUB(NOW(), INTERVAL 90 DAY)
  AND t.is_deleted = 0
GROUP BY t.name
HAVING total >= 5
ORDER BY total DESC
LIMIT 20;
Documentar o topo dessa lista reduz reaberturas e tempo de atendimento de forma mensurável. E meça pelo lado certo: a coluna view de cada artigo conta as consultas. Um artigo muito consultado está a pagar o investimento; um artigo com view perto de zero e date_mod antigo é candidato a revisão ou arquivo - não a mais um item no total.
Faça a manutenção antes de envelhecer
Uma base de conhecimento não é um projeto, é uma rotina. O GLPI guarda o histórico em glpi_knowbaseitems_revisions, por isso pode editar sem receio de perder a versão anterior. Defina um ritmo de revisão (trimestral costuma chegar), dando prioridade aos artigos mais consultados - um passo a passo errado sobre reposição de palavra-passe gera mais chamados do que a sua ausência. Um artigo desatualizado não é neutro: custa credibilidade e o técnico volta a "perguntar ao fulano".
Precisa de uma base de conhecimento que reduza mesmo os chamados, com a pesquisa afinada e a visibilidade sob controlo? Conheça a sustentação de GLPI da NexTool.
Revisto pela equipa NexTool Solutions.