Transparenz heißt nicht, mehr Berichte zu haben, sondern den Zustand der Warteschlange zu sehen, solange man noch handeln kann. GLPI speichert bereits alles, was Sie brauchen; nur sind die Daten verstreut, und die nativen Dashboards zeigen nur die Vergangenheit. Dieser Leitfaden zeigt, wo echte Transparenz in GLPI liegt, welche Diagnoseabfragen wir ausführen, wenn wir den Betrieb einer Umgebung übernehmen, wie Sie SLA-Verletzungen vorhersehen, bevor sie eintreten, und wie Sie all dies in automatische Alarme verwandeln.
Die Transparenz, die GLPI Ihnen bereits bietet, und wo sie endet
GLPI bringt Dashboards in der Zentrale und eine leistungsfähige Suche mit Filtern mit. Für den Alltag löst sie vieles: Zählungen nach Status, nach Techniker, nach Kategorie. Die Grenze zeigt sich an drei Stellen:
- Sie arbeitet auf Abruf, nicht proaktiv. Ein Dashboard aktualisiert sich nur, wenn jemand die Seite öffnet. Niemand wird benachrichtigt, wenn sich ein Engpass bildet: Sie müssen selbst nachsehen.
- Sie zählt, was Ihr Profil sieht. Die Zahl im Dashboard hängt von der Einheit und vom Profil des angemeldeten Benutzers ab. Der Koordinator einer Einheit und der globale Admin sehen unterschiedliche Summen für dieselbe Warteschlange.
- Sie zeigt die Summe, nicht vergessene Tickets. „42 offene Tickets“ sagt nicht, welches seit 20 Tagen liegt.
Echte Transparenz beginnt, wenn Sie aufhören, auf die Summe zu schauen, und anfangen, die Form der Warteschlange zu betrachten und was kurz davor ist schiefzugehen.
Schritt 1: Wohin der Rückstand wandert
Vor jedem schönen Dashboard steht als erste Röntgenaufnahme die Verteilung des Rückstands nach Gruppe und Status. Alles liegt in glpi_tickets; die Zuweisung an Gruppen in glpi_groups_tickets (Typ 2 = zugewiesen). Die relevanten Status: 1 Neu, 2/3 In Bearbeitung, 4 Ausstehend, 5 Gelöst, 6 Geschlossen.
-- Open backlog by assigned group (type 2 = assigned)
SELECT
  g.completename                    AS team,
  COUNT(*)                          AS open_tickets,
  SUM(t.status = 1)                 AS new_untriaged,
  SUM(t.status = 4)                 AS pending
FROM glpi_tickets t
JOIN glpi_groups_tickets gt
     ON gt.tickets_id = t.id AND gt.type = 2
JOIN glpi_groups g ON g.id = gt.groups_id
WHERE t.status NOT IN (5, 6)
  AND t.is_deleted = 0
GROUP BY g.id
ORDER BY open_tickets DESC;
In Sekunden sehen Sie, welche Gruppe überlastet ist und wie viel vom Rückstand neue Tickets sind, die niemand gesichtet hat: die Zahl, die native Dashboards hinter der Summe verstecken.
Schritt 2: SLA-Verletzungen erkennen, bevor sie eintreten
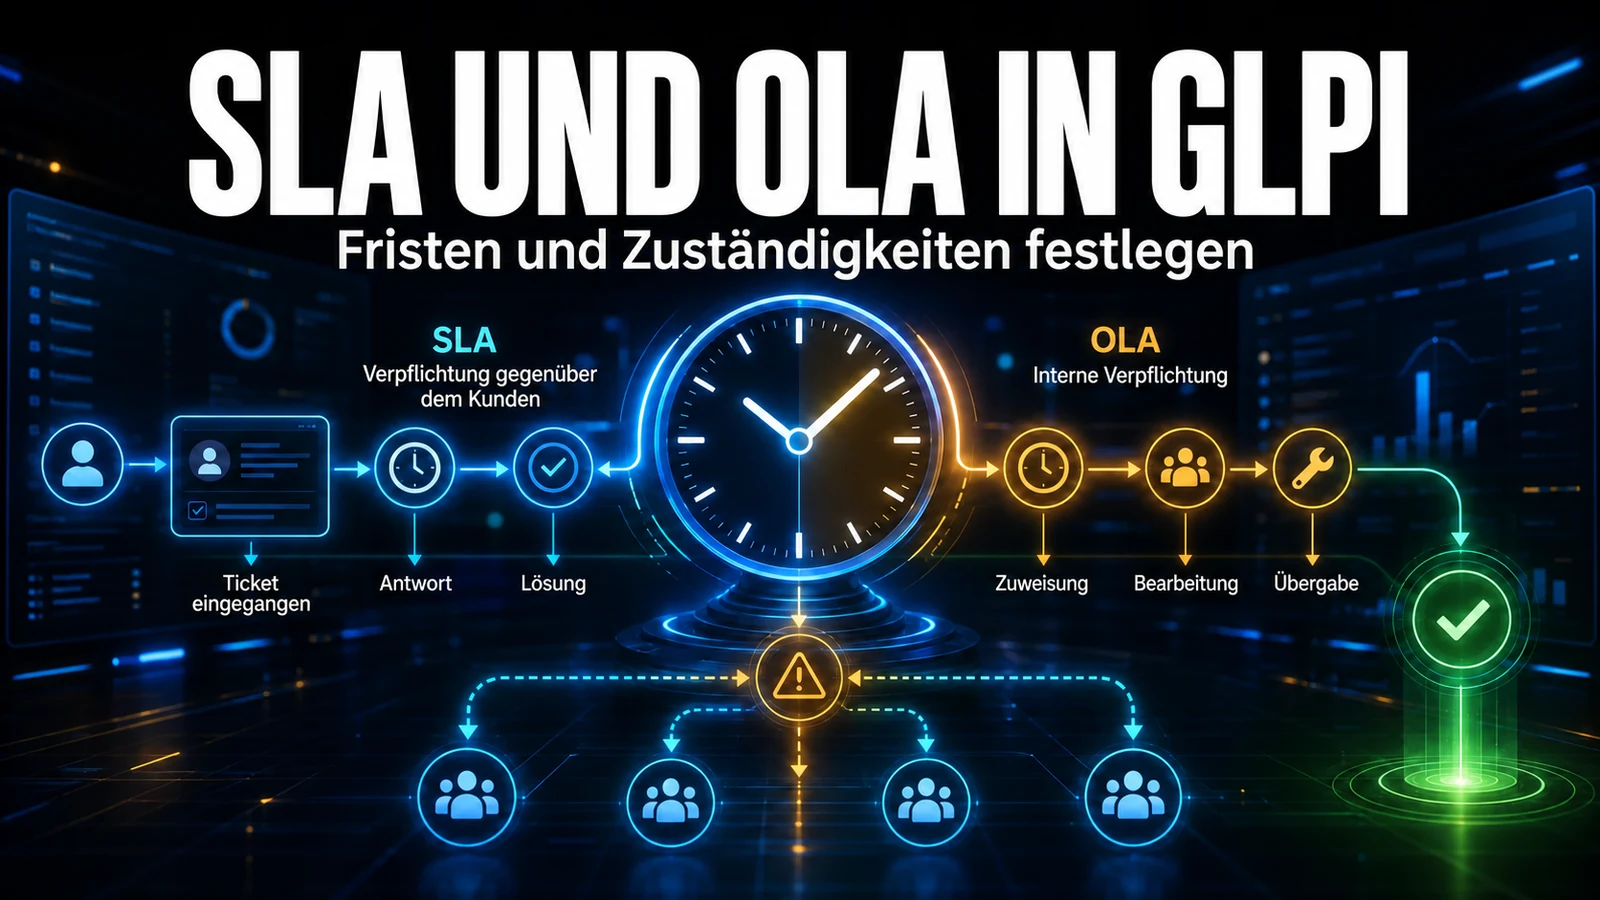
Hier liegt der Unterschied zwischen einem Betrieb, der reagiert, und einem, der vorausschaut. Wenn ein SLA auf ein Ticket zutrifft, speichert GLPI die Frist in eigenen Spalten von glpi_tickets: time_to_resolve (Lösungsfrist) und time_to_own (Zuweisungsfrist). Diese Spalten sind eine Uhr: Sie können sehen, was in den nächsten Stunden fällig wird, nicht nur, was bereits überfällig ist:
-- Open tickets whose resolution SLA breaches within the next 4h
SELECT
  t.id,
  t.name,
  t.time_to_resolve,
  TIMESTAMPDIFF(MINUTE, NOW(), t.time_to_resolve) AS minutes_left
FROM glpi_tickets t
WHERE t.status NOT IN (4, 5, 6)        -- exclude Pending, Solved, Closed
  AND t.is_deleted = 0
  AND t.time_to_resolve IS NOT NULL
  AND t.time_to_resolve > NOW()
  AND t.time_to_resolve <= NOW() + INTERVAL 4 HOUR
ORDER BY t.time_to_resolve ASC;
Die Falle aus der Praxis steckt im IS NOT NULL. Die Spalte time_to_resolve wird nur gefüllt, wenn beim Erstellen eine SLA-Regel auf ein Ticket zugetroffen hat. Ein Ticket, auf welches keine Regel passte, behält die Frist NULL und verschwindet stillschweigend aus dem Risiko-Dashboard. Mit anderen Worten: Tickets ohne SLA, also genau jene, die niemand misst, sind für jeden fristbasierten Alarm unsichtbar. Wenn wir eine Umgebung übernehmen, zählen wir zuerst, wie viele offene Tickets time_to_resolve IS NULL haben. Wir hatten schon Kunden mit 60 % des Rückstands ohne zugeordneten SLA: Ihr Dashboard meldete „alles im Zeitplan“, weil die halbe Warteschlange schlicht keine Frist hatte.
Schritt 3: Der Verantwortliche, den es nicht gibt
Ein weiterer klassischer blinder Fleck: Tickets, die nur einer Gruppe zugewiesen sind, ohne namentlichen Techniker. Auf dem Bildschirm wirken sie zugewiesen; in der Praxis fühlt sich niemand verantwortlich. Diese Tickets verschwinden aus den persönlichen Dashboards („meine Tickets“) und altern unsichtbar. Die Zuweisung an Personen liegt in glpi_tickets_users mit type = 2:
-- Open tickets assigned to a group but WITHOUT a named technician
SELECT COUNT(*) AS no_owner
FROM glpi_tickets t
WHERE t.status NOT IN (5, 6)
  AND t.is_deleted = 0
  AND NOT EXISTS (
    SELECT 1 FROM glpi_tickets_users tu
    WHERE tu.tickets_id = t.id AND tu.type = 2
  );
Die Transparenzebenen: was wofür
Es gibt kein einzelnes Werkzeug. Jede Ebene löst ein Problem und hat eine Grenze. So entscheiden wir, wo jede Kennzahl hingehört:
| Ebene | Was sie gut sieht | Echtzeit? | Wichtigste Einschränkung |
|---|---|---|---|
| Natives Dashboard (Zentrale) | Zählung nach Status, Techniker, Kategorie | aktualisiert beim Laden der Seite | benachrichtigt nicht; hängt vom angemeldeten Profil ab |
| Gespeicherte Suche + Alarm | Zählung, die einen Grenzwert überschreitet (z. B. mehr als 5 ausstehende) | läuft per Cron, sendet E-Mail | zählt nur; liefert keine detaillierten Angaben |
| Diagnose-SQL | jeder beliebige Ausschnitt (Verteilung, Stillstand, fällige SLAs) | auf Abruf | erfordert Datenbankzugriff (read-only) |
| Externes Dashboard (Metabase/Grafana) | Historie, Trend, Wand-Dashboard | geplante Aktualisierung | zusätzliche Infrastruktur zu pflegen |
Schritt 4: Diagnose in automatische Alarme verwandeln
Abfragen von Hand auszuführen skaliert nicht und hängt, schlimmer noch, davon ab, dass jemand daran denkt nachzusehen. Zwei Wege, diesen Kreis in GLPI zu schließen:
- Nativ, ohne zusätzliche Infrastruktur: Speichern Sie die Suche „SLA läuft ab“ oder „seit mehr als 7 Tagen ausstehend“ und legen Sie einen Alarm für gespeicherte Suchen an. Der Cron von GLPI führt die Suche regelmäßig aus und sendet eine E-Mail, wenn die Zählung den von Ihnen festgelegten Grenzwert überschreitet.
- Außerhalb von GLPI, für Wand-Dashboard und Historie: Planen Sie die Diagnoseabfrage im System-Cron ein und lesen Sie die Zugangsdaten aus einer
.cnf-Datei (chmod 600), damit nie ein Passwort in der Befehlszeile steht.
# /etc/cron.d/glpi-visibility  ->  every business hour, as www-data
# Lists tickets whose SLA breaches within the next 4h for the on-call queue
0 8-18 * * 1-5 www-data /usr/bin/mysql --defaults-file=/etc/glpi/kpi-ro.cnf glpi \
  < /opt/glpi-kpi/sla-breaching.sql \
  > /var/log/glpi-kpi/sla-risk-$(date +\%Y-\%m-\%d-\%H).csv 2>&1
Stellen Sie vor dem Einplanen sicher, dass der Cron von GLPI selbst tatsächlich im externen Modus läuft (der System-cron ruft front/cron.php auf); sonst werden SLA-Fristen und native Alarme gar nicht neu berechnet, und Sie messen mit einer stehenden Uhr.
Die Wende in der Betriebspraxis
Wenn wir ein GLPI eines Kunden übernehmen, ist die erste Röntgenaufnahme nie ein natives Dashboard, sondern die Zählung der Tickets, die nur einer Gruppe zugewiesen sind (ohne Verantwortlichen), und der Tickets mit leerem time_to_resolve. In einem Fall waren 40 % des Rückstands einer Gruppe von acht Personen „zugewiesen“, und niemand fühlte sich verantwortlich; keines dieser Tickets erschien in einem persönlichen Dashboard, und ältestes Ticket war 90 Tage alt. Die Lösung war kein neues Dashboard, sondern eine Geschäftsregel, die bei der Zuweisung einen namentlichen Techniker erzwingt, plus ein Alarm 4 Stunden vor der SLA-Verletzung. Transparenz kam nicht durch den Kauf eines Werkzeugs, sondern durch den Blick auf die richtigen Felder.
Häufige Fehler aus der Praxis
- Der Summe im Dashboard vertrauen: Sie aggregiert und versteckt liegengebliebene Tickets; schauen Sie auf die Verteilung nach Gruppe und Alter.
- Annehmen, dass jedes Ticket einen SLA hat:
time_to_resolve NULL= außerhalb jedes Fristalarms. Zählen Sie zuerst die Tickets ohne SLA. - „Einer Gruppe zugewiesen“ als „hat einen Verantwortlichen“ behandeln: Ohne einen Eintrag in
glpi_tickets_usersmittype = 2ist niemand verantwortlich. - Einheiten anhand derselben Zahl vergleichen: Natives Dashboard filtert bereits nach Profil und Einheit; die Summe ändert sich je nach angemeldetem Benutzer.
is_deleted = 0vergessen: Der Papierkorb von GLPI verschwindet nicht aus der Tabelle und verfälscht jede Zählung.- Bei stehendem Cron messen: Ohne laufenden externen Cron werden SLA und native Alarme nicht aktualisiert.
Nächster Schritt
Beginnen Sie mit den drei Zählungen aus diesem Leitfaden (ohne Verantwortlichen, ohne SLA, fällige SLAs), bringen Sie die Ausschnitte in ein Dashboard in Metabase oder Grafana und verknüpfen Sie die Service-Desk-KPIs mit Alarmen. So ist die Warteschlange keine Zahl am Monatsende mehr, sondern ein Signal, welches auslöst, solange Sie noch handeln können.
Bei NexTool ist diese Transparenz-Röntgenaufnahme unser erstes Ergebnis, wenn wir den Betrieb eines GLPI übernehmen: Wir erfassen blinde Flecken, schalten Alarme ein und liefern ein Dashboard. Wenn Sie diese Begleitung für Ihre Umgebung wünschen, lernen Sie unseren Support- und Betriebsservice kennen.
Geprüft vom Team von NexTool Solutions.