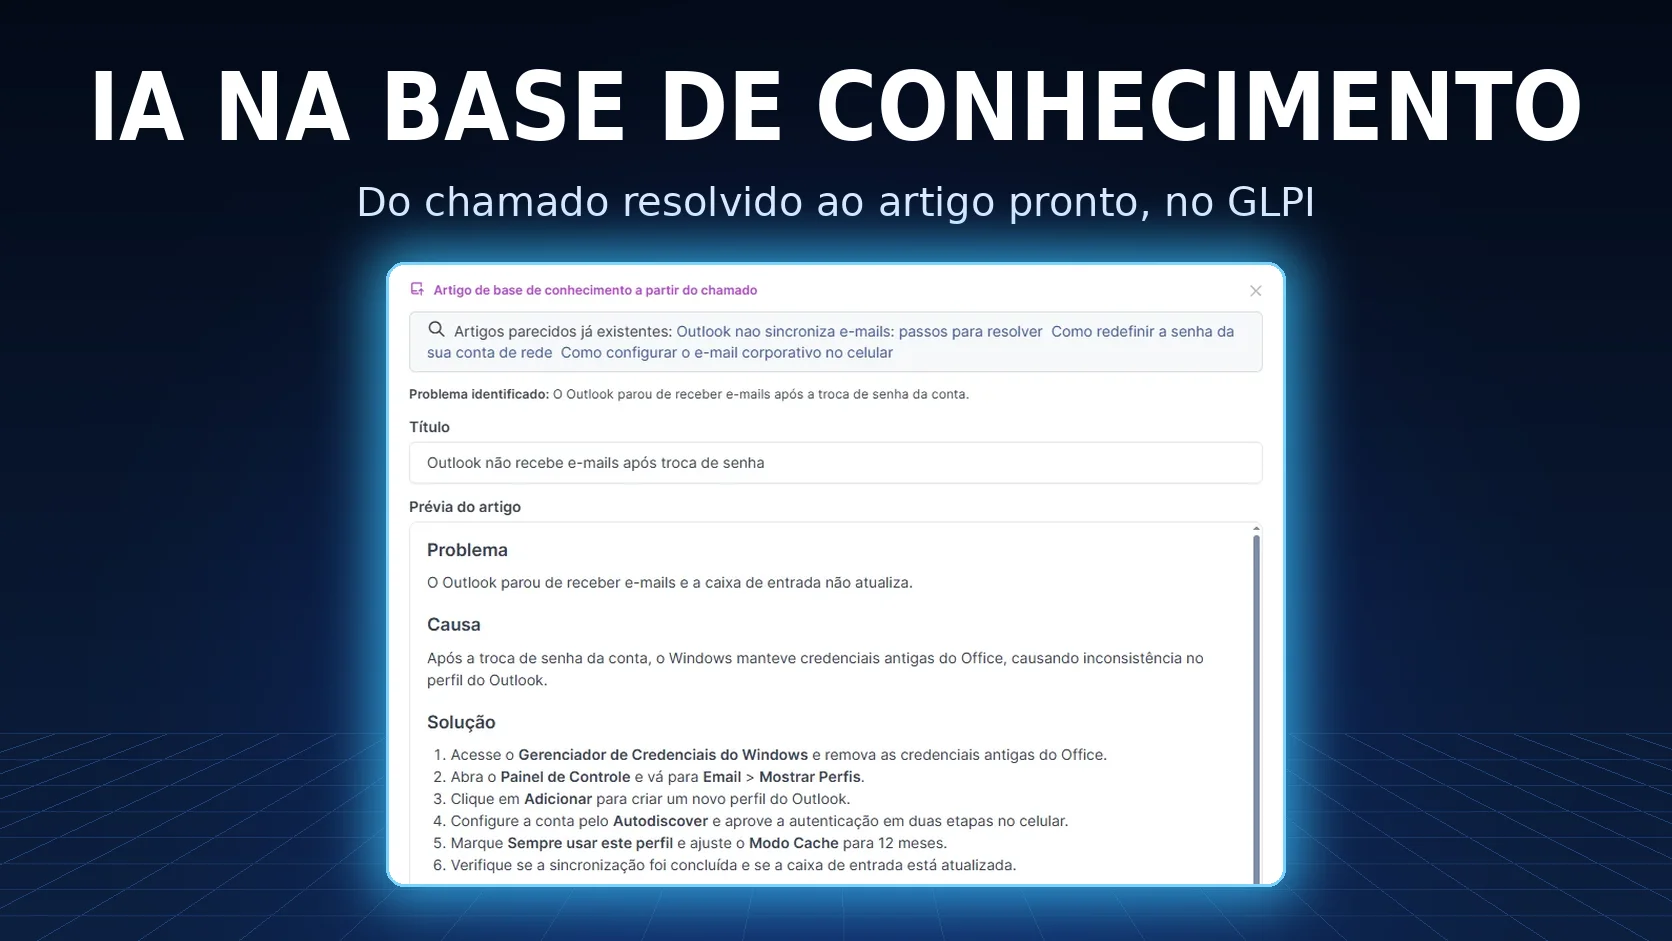
Le savoir qui vit dans la tête d'un technicien meurt lorsqu'il part - mais une base de connaissances mal configurée est pire : elle ressemble à de la documentation et ne renvoie aucun résultat. Dans la maintenance de parcs GLPI pour des clients, les deux échecs les plus fréquents sont les articles que personne ne trouve (problème de configuration) et les articles que personne n'écrit (problème d'adhésion). Ce guide traite les deux, avec les requêtes et les réglages que nous exécutons sur le terrain.
Concevez la taxonomie avant le premier article
La base de connaissances de GLPI est native (table glpi_knowbaseitems) et propose déjà des catégories, une FAQ, la recherche plein texte, le contrôle de visibilité, l'historique des révisions et le lien vers les tickets. L'erreur courante est de commencer par les articles et de laisser l'arbre de catégories grandir tout seul : six mois plus tard, vous avez douze niveaux et plus personne ne trouve rien. Verrouillez la structure d'abord :
- Deux niveaux de catégorie au maximum. S'il en faut un troisième, c'est probablement une étiquette, pas une catégorie.
- Des titres orientés action : « Comment réinitialiser un mot de passe AD » vaut mieux que « Active Directory ». L'utilisateur cherche par l'action, pas par le système.
- Quatre familles couvrent 90 % des cas : Comment faire (tutoriels), Résolution de problèmes (erreurs connues), Politiques (règles) et FAQ (publique).
- Un article peut appartenir à plusieurs catégories dans GLPI 10/11 (table glpi_knowbaseitems_knowbaseitemcategories). À utiliser avec parcimonie : trop de catégories équivaut à aucune.
L'erreur qui fait « disparaître » les articles : la visibilité
En maintenance, la panne numéro 1 que nous rencontrons n'est pas l'absence d'article - c'est un article publié que personne ne voit. Le technicien le rédige, l'enregistre, le marque comme publié et suppose qu'il est en ligne. Mais la visibilité de GLPI fonctionne par cible explicite : si personne n'a ajouté un profil, un groupe, une entité ou un utilisateur dans l'onglet des destinataires, l'article n'est visible que par son auteur - et GLPI n'émet aucun avertissement. Nous avons audité des bases de centaines d'articles où des dizaines étaient dans ces limbes. C'est pourquoi, lors de l'onboarding de maintenance, la première chose que nous exécutons est la requête des articles orphelins de visibilité, avant même de parler de taxonomie ou d'adhésion :
-- Articles NON-FAQ sans aucune cible de visibilite :
-- ils existent, comptent dans le total et sont invisibles pour tous, sauf l'auteur.
SELECT k.id, k.name
FROM glpi_knowbaseitems k
LEFT JOIN glpi_knowbaseitems_profiles p ON p.knowbaseitems_id = k.id
LEFT JOIN glpi_knowbaseitems_users    u ON u.knowbaseitems_id = k.id
LEFT JOIN glpi_groups_knowbaseitems   g ON g.knowbaseitems_id = k.id
LEFT JOIN glpi_entities_knowbaseitems e ON e.knowbaseitems_id = k.id
WHERE k.is_faq = 0
  AND p.knowbaseitems_id IS NULL
  AND u.knowbaseitems_id IS NULL
  AND g.knowbaseitems_id IS NULL
  AND e.knowbaseitems_id IS NULL;
Un détail qui ne mord que celui qui écrit cette requête : les noms des quatre tables de visibilité ne sont pas symétriques. Les utilisateurs et les profils utilisent glpi_knowbaseitems_users et glpi_knowbaseitems_profiles, mais les groupes et les entités s'inversent en glpi_groups_knowbaseitems et glpi_entities_knowbaseitems. Inverser l'ordre, c'est passer des heures à déboguer un LEFT JOIN qui ne correspond jamais.
Pourquoi « AD », « VM » et « PC » ne renvoient rien à la recherche
La recherche de la base n'est pas un LIKE : GLPI construit un MATCH(name, answer) AGAINST(... IN BOOLEAN MODE) sur l'index FULLTEXT de la table. Sous MariaDB/MySQL avec InnoDB (par défaut dans GLPI 10 et 11), innodb_ft_min_token_size définit la longueur minimale de mot indexé, et la valeur par défaut est 3. Conséquence : les sigles de deux lettres - « AD », « VM », « PC », « SI », « BD » - n'entrent pas dans l'index, et les rechercher renvoie du vide même s'il existe des dizaines d'articles qui les citent. C'est la raison numéro 1 du « la recherche de la base ne sert à rien » que nous entendons des clients. Diagnostic :
SHOW VARIABLES LIKE 'innodb_ft_min_token_size';Abaissez la limite à 2 dans le fichier de configuration de MariaDB et redémarrez le service :
# /etc/mysql/mariadb.conf.d/50-server.cnf  (MariaDB)
[mysqld]
innodb_ft_min_token_size = 2
La partie que presque tout le monde oublie : changer la variable ne réindexe pas les articles existants. Le token size est gravé à la création de l'index, il faut donc le reconstruire. Le plus direct est de forcer la reconstruction de la table :
-- Redemarrez MariaDB et reconstruisez l'index FULLTEXT
-- (le nouveau token size ne s'applique qu'apres recreation de l'index) :
ALTER TABLE glpi_knowbaseitems ENGINE=InnoDB;
L'erreur courante est d'abaisser le token à 2, de redémarrer et de crier victoire - la variable change, mais l'ancien index continue d'ignorer les sigles jusqu'à sa reconstruction. Sur les installations héritées en MyISAM, le paramètre équivalent est ft_min_word_len.
Fenêtre de validité : l'article qui n'apparaît que demain
Un autre piège silencieux, ce sont les champs begin_date et end_date de l'article. GLPI exclut de la recherche tout article dont le begin_date est dans le futur ou dont le end_date est déjà passé. C'est pratique pour publier une procédure seulement à partir d'une date - mais c'est aussi la cause classique du « j'ai créé l'article et il n'apparaît pas » : quelqu'un a rempli une date de début par mégarde. Si un article tout neuf ne remonte pas à la recherche et que la visibilité est correcte, vérifiez la fenêtre de validité avant toute autre chose.
FAQ publique en libre-service
Pour qu'un article apparaisse sur le portail de l'utilisateur final, marquez-le comme FAQ (champ is_faq) et définissez la visibilité par entité avec l'option récursive activée, afin de la propager aux sous-entités. Si vous voulez la FAQ accessible sans connexion, activez la FAQ pour les utilisateurs anonymes dans les paramètres d'Assistance de GLPI. La matrice que nous utilisons pour décider où chaque article vit :
| Objectif | is_faq | Cible de visibilité | Où il apparaît |
|---|---|---|---|
| FAQ publique (libre-service) | 1 | Entité + récursif | Portail de l'utilisateur ; sans connexion si la FAQ anonyme est activée |
| Base technique interne | 0 | Profil (ex. Technicien) | Onglet Base de connaissances, seuls les profils autorisés |
| Procédure par client | 0 | Entité spécifique | Seuls les techniciens de cette entité |
| Brouillon / en révision | 0 | Aucune (auteur seul) | Invisible - à utiliser volontairement, jamais par oubli |
Notez la dernière ligne : « aucune cible » est un état valide pour un brouillon, mais ce doit être un choix conscient, jamais le résultat d'un oubli de la visibilité.
Adhésion : le KPI qui fonctionne (et celui qui échoue)
Le KPI « X articles par technicien et par mois » que la littérature ITSM adore produit du déchet : des articles écrits pour atteindre un chiffre que personne ne consulte. Ce qui fonctionne en pratique, c'est de rattacher la création au travail qui a déjà lieu - la clôture de tickets de catégories récurrentes. Au lieu d'exiger du volume, repérez le répétitif et transformez-le en article. Cette requête liste les sujets qui se sont le plus répétés sur les 90 derniers jours, les candidats au meilleur retour :
-- Sujets de ticket repetes sur les 90 derniers jours :
-- les candidats au meilleur retour pour devenir des articles de la base.
SELECT t.name AS sujet, COUNT(*) AS total
FROM glpi_tickets t
WHERE t.date >= DATE_SUB(NOW(), INTERVAL 90 DAY)
  AND t.is_deleted = 0
GROUP BY t.name
HAVING total >= 5
ORDER BY total DESC
LIMIT 20;
Documenter le haut de cette liste réduit les réouvertures et le temps de traitement de façon mesurable. Et mesurez du bon côté : la colonne view de chaque article compte les consultations. Un article très consulté rembourse l'investissement ; un article avec un view proche de zéro et un date_mod ancien est candidat à révision ou archivage - pas à un élément de plus dans le total.
Entretenez-la avant qu'elle ne vieillisse
Une base de connaissances n'est pas un projet, c'est une routine. GLPI conserve l'historique dans glpi_knowbaseitems_revisions, vous pouvez donc éditer sans crainte de perdre la version précédente. Fixez un rythme de révision (le trimestriel suffit souvent), en priorisant les articles les plus consultés - un pas-à-pas erroné sur la réinitialisation de mot de passe génère plus de tickets que son absence. Un article obsolète n'est pas neutre : il coûte en crédibilité et le technicien revient à « demander à untel ».
Besoin d'une base de connaissances qui réduit vraiment les tickets, avec une recherche affinée et une visibilité sous contrôle ? Découvrez le service de maintenance GLPI de NexTool.
Révisé par l'équipe NexTool Solutions.