Un champ personnalisé dans GLPI est une décision d'architecture, pas un clic. La bonne question n'est pas "Fields ou natif ?", mais plutôt : la donnée que vous devez stocker est-elle un attribut de quelque chose qui existe déjà, ou une nouvelle chose avec une vie propre ? Cette réponse définit l'outil - et le coût que vous payez pendant les années à venir.
Ce que chaque approche résout vraiment
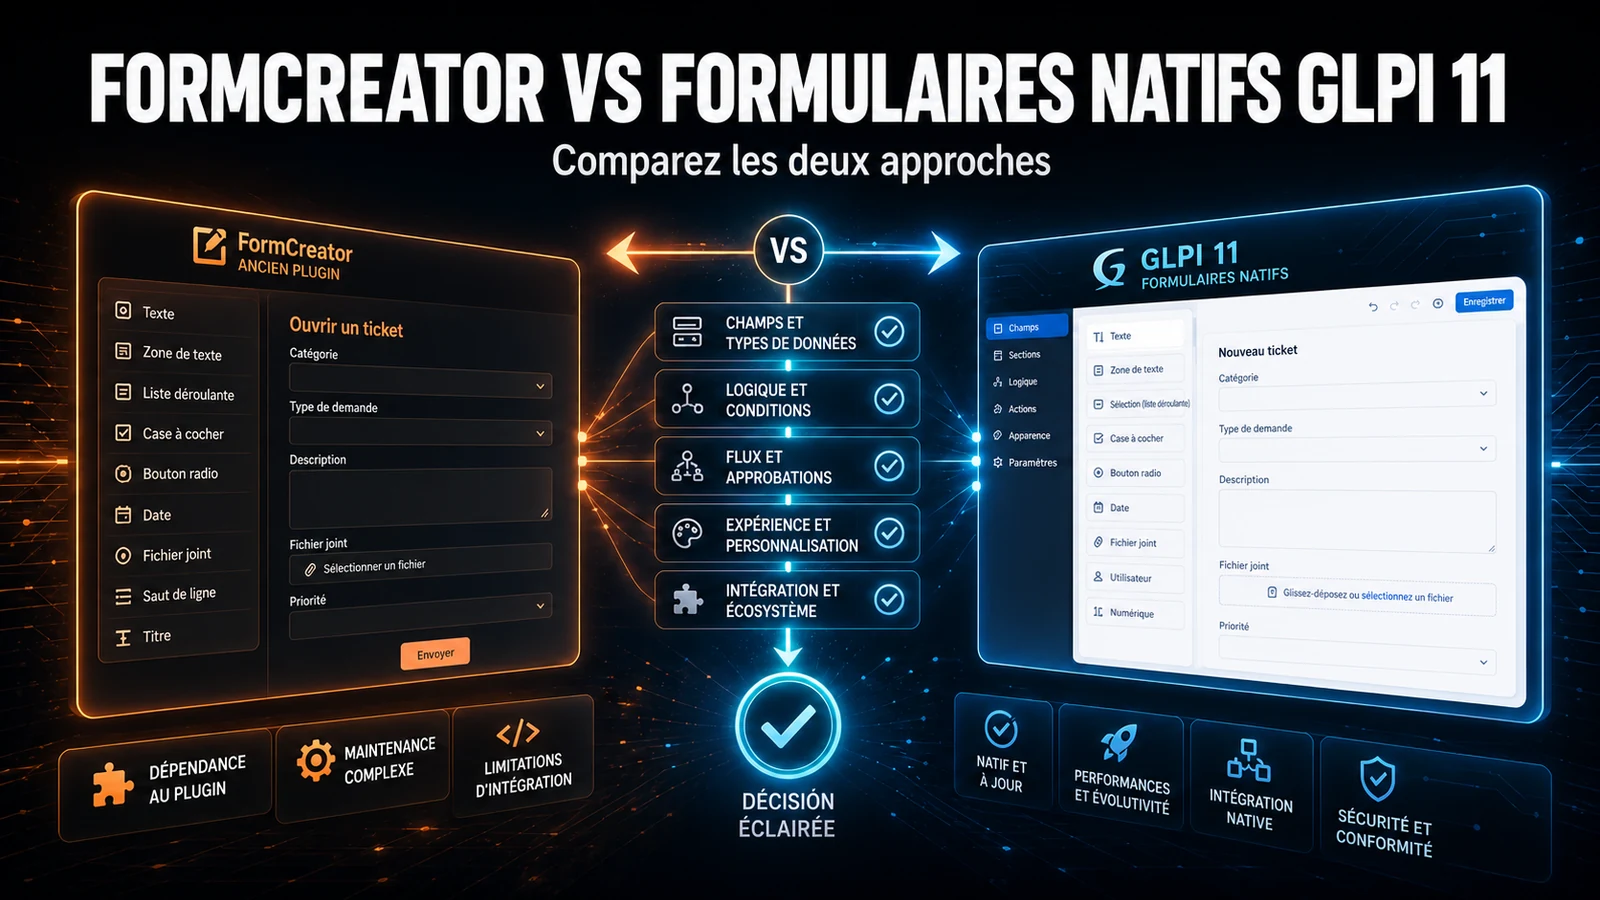
Le plugin Fields (maintenu par Teclib) accroche des champs supplémentaires à des types d'élément qui existent déjà dans GLPI : ticket, ordinateur, utilisateur, contrat, fournisseur. Vous créez un conteneur (un bloc de champs), choisissez sur quels types il apparaît et ajoutez des champs texte, liste déroulante, date, nombre, oui/non et URL. Il reste la façon pratique de dire "chaque ticket a besoin d'un champ Centre de Coût".
Les objets personnalisés de GLPI 11 (actifs personnalisés) résolvent un autre problème : créer un nouveau type d'élément directement dans le cœur, sans plugin. C'est le remplaçant officiel de l'ancien GenericObject. Vous définissez "Véhicule", "Salle de Réunion" ou "Équipement de Laboratoire" avec leurs propres champs, et il se comporte comme un actif de première classe : il entre dans l'inventaire, se lie aux tickets, apparaît dans les rapports.
Pour résumer la frontière : Fields ajoute des attributs à quelque chose qui existe ; un objet natif crée l'entité. Confondre les deux est à l'origine de presque tous les problèmes de maintenance qui apparaissent plus tard.
Comparatif direct
| Critère | Plugin Fields | Objet personnalisé (GLPI 11 natif) |
|---|---|---|
| Ce qu'il fait | Ajoute des champs à des types déjà existants | Crée un nouveau type d'élément |
| Dépend d'un plugin | Oui - dépendance dure lors d'une mise à niveau majeure | Non - il est dans le cœur |
| Où sont stockées les données | Une table par conteneur, parallèle au cœur | Dans le schéma natif de GLPI |
| Champs conditionnels / par profil | Oui, mais la visibilité est de l'affichage, pas de la sécurité | Pas de logique conditionnelle native |
| Recherche et rapports | Search options avec un LEFT JOIN par conteneur | Search options natives, sans table en plus |
| Intégration inventaire | Ne reçoit pas de données d'inventaire | Oui, c'est un actif inventoriable |
| Migration GLPI 10 vers 11 | Nécessite une version du plugin compatible avec le nouveau cœur | Destination officielle de GenericObject |
| Effort pour démarrer | Minutes pour un champ | Heures pour modéliser un type |
| Idéal pour | Attributs de quelque chose qui existe déjà | Une nouvelle entité avec une vie propre |
Où vivent les données (et pourquoi cela compte)
Chaque conteneur Fields devient une table dédiée dans la base, avec une ligne par élément et une colonne par champ. Avant de décider, il vaut la peine de voir ce qui existe déjà dans l'environnement :
-- Ou le plugin Fields stocke les valeurs : une table par conteneur,
-- avec une ligne par element et une colonne par champ personnalise.
SELECT table_name AS table_de_conteneur
FROM information_schema.tables
WHERE table_schema = DATABASE()
  AND table_name LIKE 'glpi_plugin_fields_%'
ORDER BY table_name;

-- Definitions : conteneurs (a quels types ils s'appliquent) et leurs champs
SELECT c.name AS conteneur, c.itemtypes, f.name AS champ, f.type
FROM glpi_plugin_fields_containers c
JOIN glpi_plugin_fields_fields f
  ON f.plugin_fields_containers_id = c.id
ORDER BY c.name, f.ranking;
Cela compte pour deux raisons opérationnelles. D'abord : chaque champ Fields marqué comme recherchable devient une search option, et le moteur de recherche de GLPI la résout avec un LEFT JOIN supplémentaire sur la table du conteneur. Chez un client avec 15 conteneurs ou plus sur Ticket, la liste des tickets commence à ralentir - pas à cause du volume de données, mais du nombre de JOINs dans le SELECT de la recherche. Ensuite : les objets natifs écrivent dans le schéma du cœur, donc ils sortent en export, API et rapport avec le même traitement que les champs standard, sans table parallèle à réconcilier.
Le compromis qui apparaît en maintenance
Quand on maintient des parcs GLPI pour des clients, le vrai coût de Fields n'est pas de l'installer - c'est le jour de la mise à niveau majeure. Fields est une dépendance dure : lors d'une migration de GLPI 10 vers 11, l'environnement ne démarre que lorsqu'il existe une version du plugin compatible avec le nouveau cœur. Nous avons déjà retenu la fenêtre de mise à niveau d'un client en attendant que le plugin publie la build compatible, avec des dizaines de conteneurs en production qu'on ne pouvait pas simplement éteindre. Un objet natif n'a pas ce verrou : il est le cœur, il monte avec lui.
Deux erreurs fréquentes que nous corrigeons souvent. La première est de modéliser une entité entière comme un tas de champs sur le ticket - "Contrat de maintenance" devenant 12 champs Fields sur Ticket, impossible à lister, filtrer ou relier correctement ; il fallait là un objet (ou le module Contrats de GLPI lui-même). La seconde est l'inverse : créer un actif personnalisé entier pour ce qui n'était que deux attributs organisationnels sur un type existant - de la complexité de modélisation sans retour. Et un avertissement que nous donnons toujours : cacher un champ Fields par profil, c'est de l'affichage, pas de la sécurité. La valeur reste dans la base et fuit via API, export ou recherche. Si la donnée est sensible, le contrôle doit être ailleurs.
Verdict par scénario
Utilisez Fields quand la donnée est un attribut d'un type qui existe déjà et que vous ne voulez pas gérer un nouveau type : centre de coût et projet sur le ticket, numéro d'inventaire interne sur l'ordinateur, matricule sur l'utilisateur, champs obligatoires ou conditionnels par catégorie de ticket. C'est rapide, sans interruption et sans migration de schéma à administrer.
Utilisez un objet personnalisé natif quand la "chose" a une vie propre et que vous allez la lister, la filtrer et la lier aux tickets comme un élément : véhicules, salles, actifs de laboratoire, équipements qui n'entrent dans aucun type standard. Et, obligatoirement, quand vous quittez GenericObject dans la migration vers GLPI 11 - c'est le chemin de remplacement officiel.
Les deux coexistent. Il est légitime d'avoir un actif personnalisé pour l'entité et d'utiliser tout de même Fields pour accrocher l'un ou l'autre attribut organisationnel sur des tickets qui référencent cet actif. Ce qui ne va pas, c'est d'utiliser l'un pour faire le travail de l'autre.
Coût et effort
Licence : les deux sont gratuits (GPL). Le vrai coût est la maintenance. Fields facture en risque de dépendance à chaque mise à niveau majeure et en poids de recherche à mesure que les conteneurs grandissent. Un objet natif facture en modélisation initiale - vous concevez un type, vous n'ajoutez pas seulement un champ - mais ensuite il ne pèse ni sur la mise à niveau ni sur un JOIN parallèle. Comme fourchette honnête : ajouter un champ Fields prend des minutes ; modéliser un actif personnalisé bien fait prend de quelques heures à une journée, en comptant champs, profils et intégration à l'inventaire.
Chez NexTool nous déployons et maintenons les deux approches sur le GLPI de nos clients. Si vous hésitez entre accrocher plus de champs ou modéliser un objet - ou si vous devez quitter GenericObject sans casser l'historique - notre conseil GLPI aide à trancher avant que cela devienne de la dette technique.
Révisé par l'équipe NexTool Solutions.