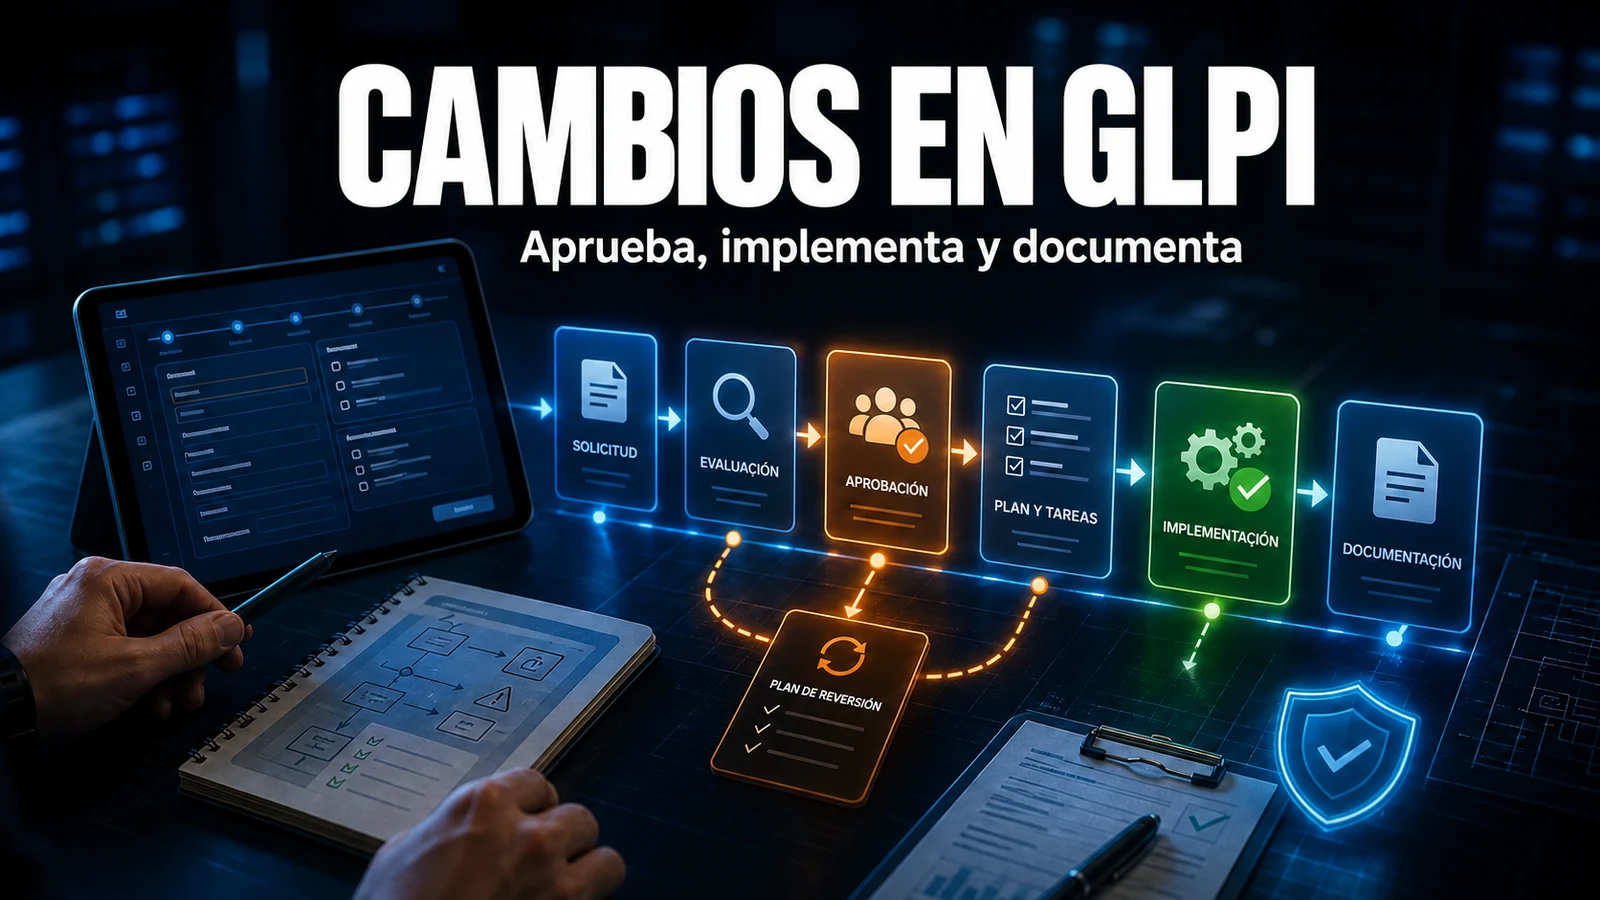
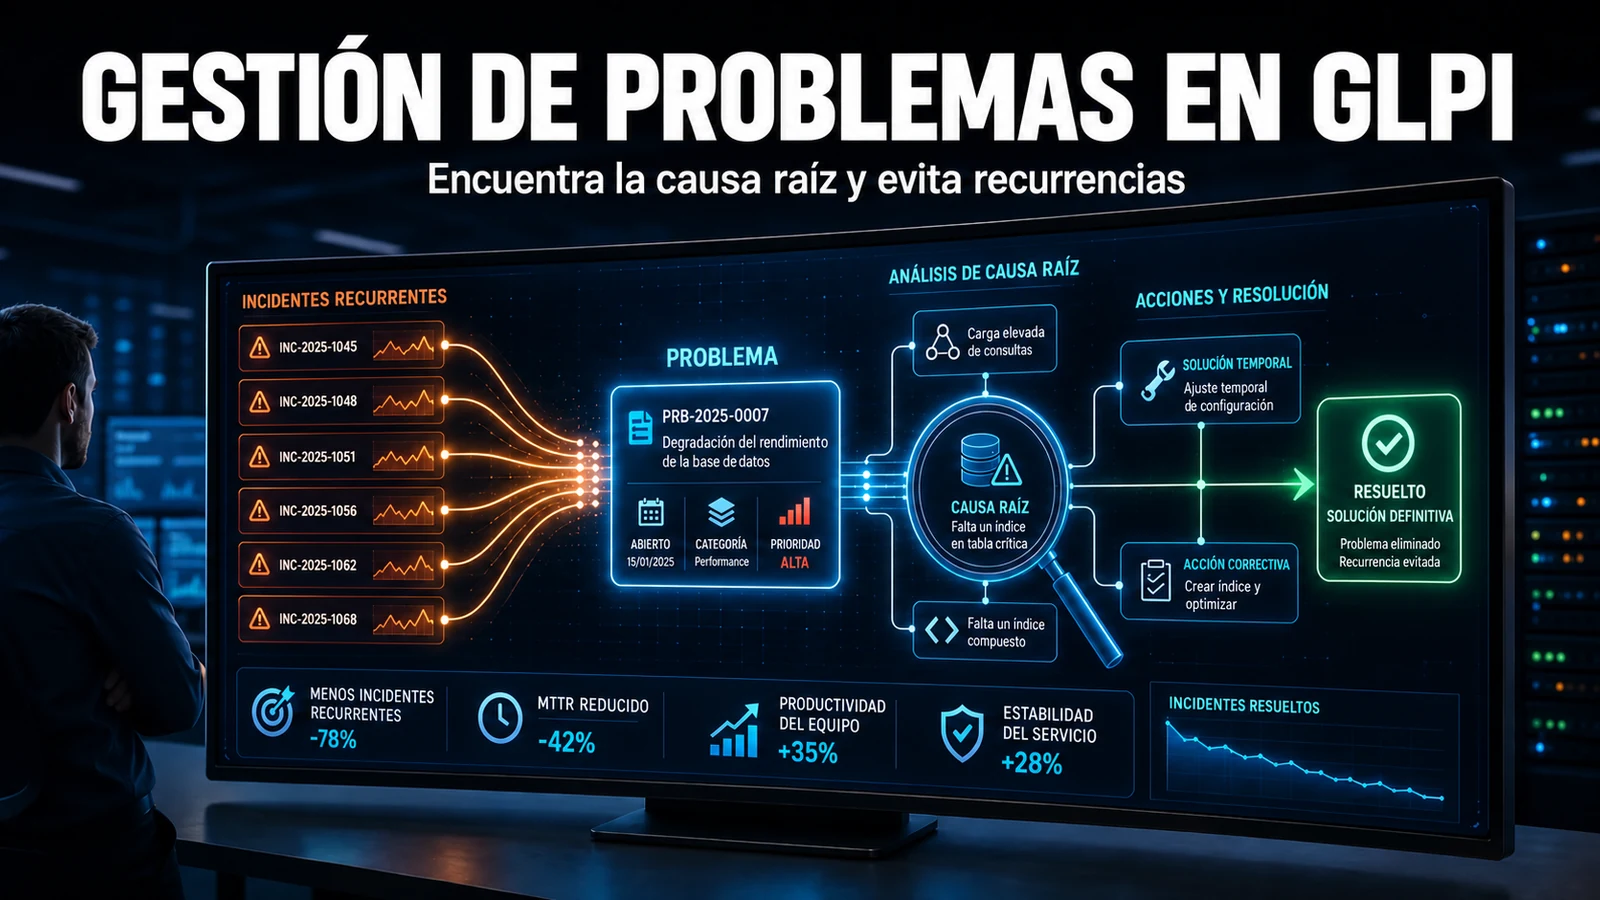
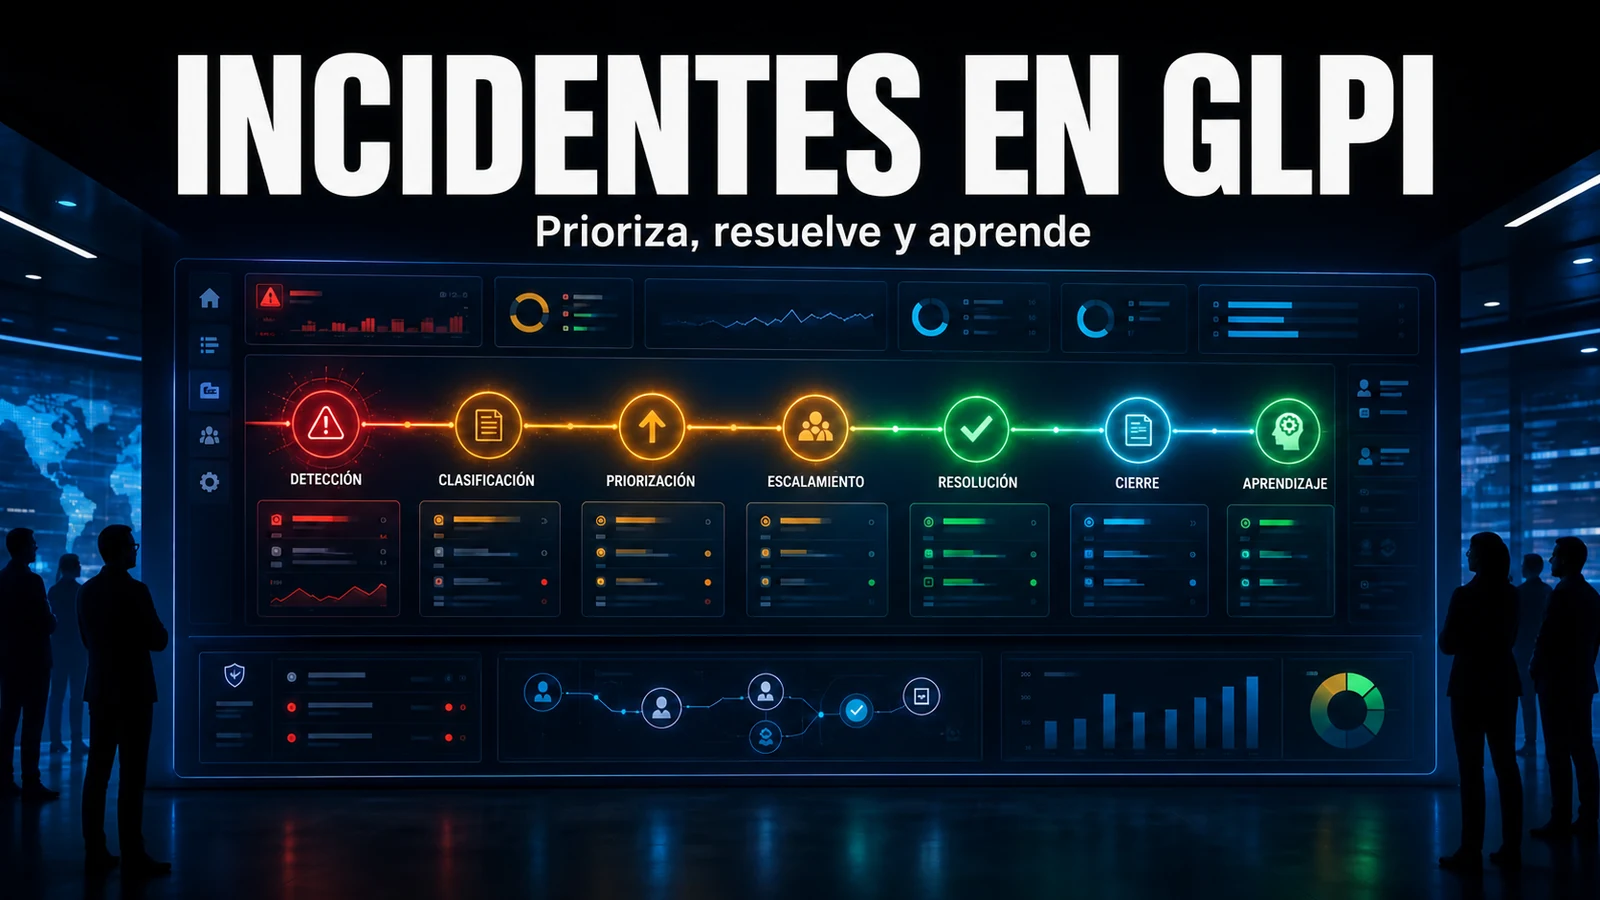
Saber dónde estás es el primer paso para saber hacia dónde ir. Esta guía muestra cómo evaluar el nivel de madurez ITSM de tu operación con señales objetivas extraídas del propio GLPI - sin depender de la percepción - y cómo priorizar los próximos pasos de evolución.
La madurez no se mide por opinión
La pregunta "¿en qué nivel estamos?" casi siempre recibe una respuesta emocional: quien apaga incendios todos los días jura estar en el nivel 1, y el gestor que aprobó la compra de la herramienta jura estar en el nivel 4. Los dos se equivocan, porque miden una sensación, no un proceso. La madurez ITSM es el grado de formalización, automatización y optimización de la gestión de servicios, y deja rastros medibles en la base de datos de la herramienta. Antes de contratar consultoría o comprar más módulos, conviene extraer esos rastros.
Diagnóstico objetivo: pregúntale al propio GLPI
Tres señales separan bien una operación madura de una inmadura: cuántos tickets están realmente categorizados, cuántos tienen un SLA vinculado y cuánto tardan en resolverse. Ejecuta la consulta siguiente directamente en la base de datos (solo lectura) sobre los últimos 90 días:
-- Senales de madurez en los ultimos 90 dias (GLPI 10/11)
SELECT
  COUNT(*)                                               AS total_tickets,
  ROUND(100 * SUM(itilcategories_id > 0) / COUNT(*), 1) AS pct_categorizados,
  ROUND(100 * SUM(slas_id_ttr > 0) / COUNT(*), 1)       AS pct_con_sla_resolucion,
  ROUND(AVG(TIMESTAMPDIFF(HOUR, date, solvedate)), 1)   AS horas_medias_para_resolver
FROM glpi_tickets
WHERE date >= DATE_SUB(NOW(), INTERVAL 90 DAY)
  AND is_deleted = 0
  AND solvedate IS NOT NULL;
Lectura de campo: por debajo del 70% de tickets categorizados, olvida la gestión de problemas - no tienes base para agrupar recurrencias. Por debajo del 50% con un SLA vinculado, tus informes de cumplimiento solo miden la fracción que tiene plazo, no toda la operación. Y si el promedio de horas hasta resolver oscila mucho de mes a mes, el proceso sigue siendo ad-hoc aunque exista una herramienta.
Matriz: nivel x señal en GLPI x acción
Usa la matriz para ubicar tu nivel por lo que GLPI muestra hoy, no por lo que te gustaría que mostrara:
| Nivel | Señal observable en GLPI | Próxima acción técnica | Métrica objetivo |
|---|---|---|---|
| 1 - Ad-hoc | Sin herramienta, o tickets sin categoría/SLA | Implantar GLPI, crear entidad y perfiles | 100% de los tickets en la herramienta |
| 2 - Repetible | Tickets abiertos, pero domina la categoría "Otros" | Árbol de categorías reducido + SLA inicial | >70% categorizados |
| 3 - Definido | Categorías y SLA en uso; asignación manual | Reglas de negocio (asignación), base de conocimiento | SLA vinculado >90% |
| 4 - Gestionado | Métricas recogidas; cron en CLI | Gestión de problemas y de cambios, cuadros de mando | SLA cumplido >90% |
| 5 - Optimizado | Decisión por dato; automatización madura | Análisis de recurrencia, integración con el negocio | Caída año tras año de reincidencia |
El detalle de soporte que falsea toda métrica
En el soporte de entornos de clientes, el indicador que más engaña es el "SLA cumplido" cuando las acciones automáticas de GLPI se ejecutan en modo GLPI (disparadas por el navegador) en lugar de CLI. En ese modo, el recálculo de plazos, las escalaciones y las notificaciones solo ocurren cuando alguien abre una página del sistema. Resultado: a las 3 de la mañana, sin nadie conectado, ningún ticket se escala, y el informe del día siguiente muestra un SLA verde que no corresponde a la realidad. El error común es confiar en el cuadro de mando sin comprobar, en Configuración > Acciones automáticas, cuál es el modo de ejecución. La corrección es estandarizar todo en CLI y programar el cron del sistema:
# /etc/cron.d/glpi  - ejecuta las acciones automaticas cada minuto
# Sirve para GLPI 10 y 11 (front/cron.php es portable; en el 11 evita depender de la consola)
* * * * * www-data /usr/bin/php /var/www/html/glpi/front/cron.php &>/dev/null
Tras migrar a CLI, en Acciones automáticas cambia el modo de ejecución de cada tarea crítica (queuednotification, slaticket, closeticket) a CLI. Sin esto, puedes estar en el nivel 4 sobre el papel y en el nivel 2 en la práctica.
La trampa del árbol de categorías heredado
Otro tropiezo recurrente: subir de nivel creyendo que "tener muchas categorías" es señal de madurez. Es lo contrario. Asumimos el soporte de un entorno que traía unas 400 categorías importadas de un sistema heredado, anidadas en cinco niveles. En la práctica, los agentes no encontraban la categoría correcta, elegían la primera que aparecía y el campo se convertía en ruido. Recategorizamos el histórico de los últimos meses, recortamos el árbol a poco más de dos docenas de categorías que reflejaban lo que el equipo realmente atiende, y solo entonces los informes por causa empezaron a tener sentido. La regla práctica que usamos: si una categoría no recibe un ticket desde hace 90 días, es candidata a desaparecer. Demasiadas categorías no miden la madurez; estorban la clasificación y falsean cualquier análisis de recurrencia.
Checklist de evaluación rápida
- ¿Existe una herramienta ITSM con todos los tickets dentro de ella? (sí = nivel 2+)
- ¿Más del 70% de los tickets están en una categoría específica, no "Otros"? (sí = nivel 3+)
- ¿El SLA está vinculado y el cron se ejecuta en CLI validado? (sí = nivel 3+)
- ¿Las métricas se recogen y se revisan en una reunión fija? (sí = nivel 4+)
- ¿Las decisiones salen del dato, no de la percepción? (sí = nivel 4+)
- ¿Hay gestión de problemas activa reduciendo la recurrencia? (sí = nivel 5)
Plan de evolución: un nivel cada vez
No intentes saltarte etapas - cada nivel se apoya en el anterior. Si el diagnóstico mostró categorización baja, el próximo paso no es comprar IA; es reducir el árbol de categorías a lo que el equipo usa realmente (en la práctica, de 15 a 25 categorías cubren la mayoría de las operaciones de tamaño medio) y entrenar la clasificación inicial. Solo cuando la categorización se estabiliza tiene sentido la gestión de problemas, porque por fin puedes agrupar incidencias por causa. Si estás en el nivel 1-2, empieza por la implantación de GLPI y la configuración básica antes de cualquier automatización.
En nuestra experiencia de soporte, la ganancia de madurez más rápida no viene de una función nueva, sino de higienizar lo que ya existe: cron en CLI, categorías reducidas y un SLA vinculado al 100% de los tipos de ticket. Estos tres ajustes mueven una operación del nivel 2 al 3 en pocas semanas, sin coste de licencia adicional.
Si quieres un diagnóstico de madurez con estos indicadores extraídos de tu propio entorno, NexTool evalúa y da soporte a GLPI para operaciones B2B - desde la configuración básica hasta el nivel optimizado.
Revisado por el equipo de NexTool Solutions.