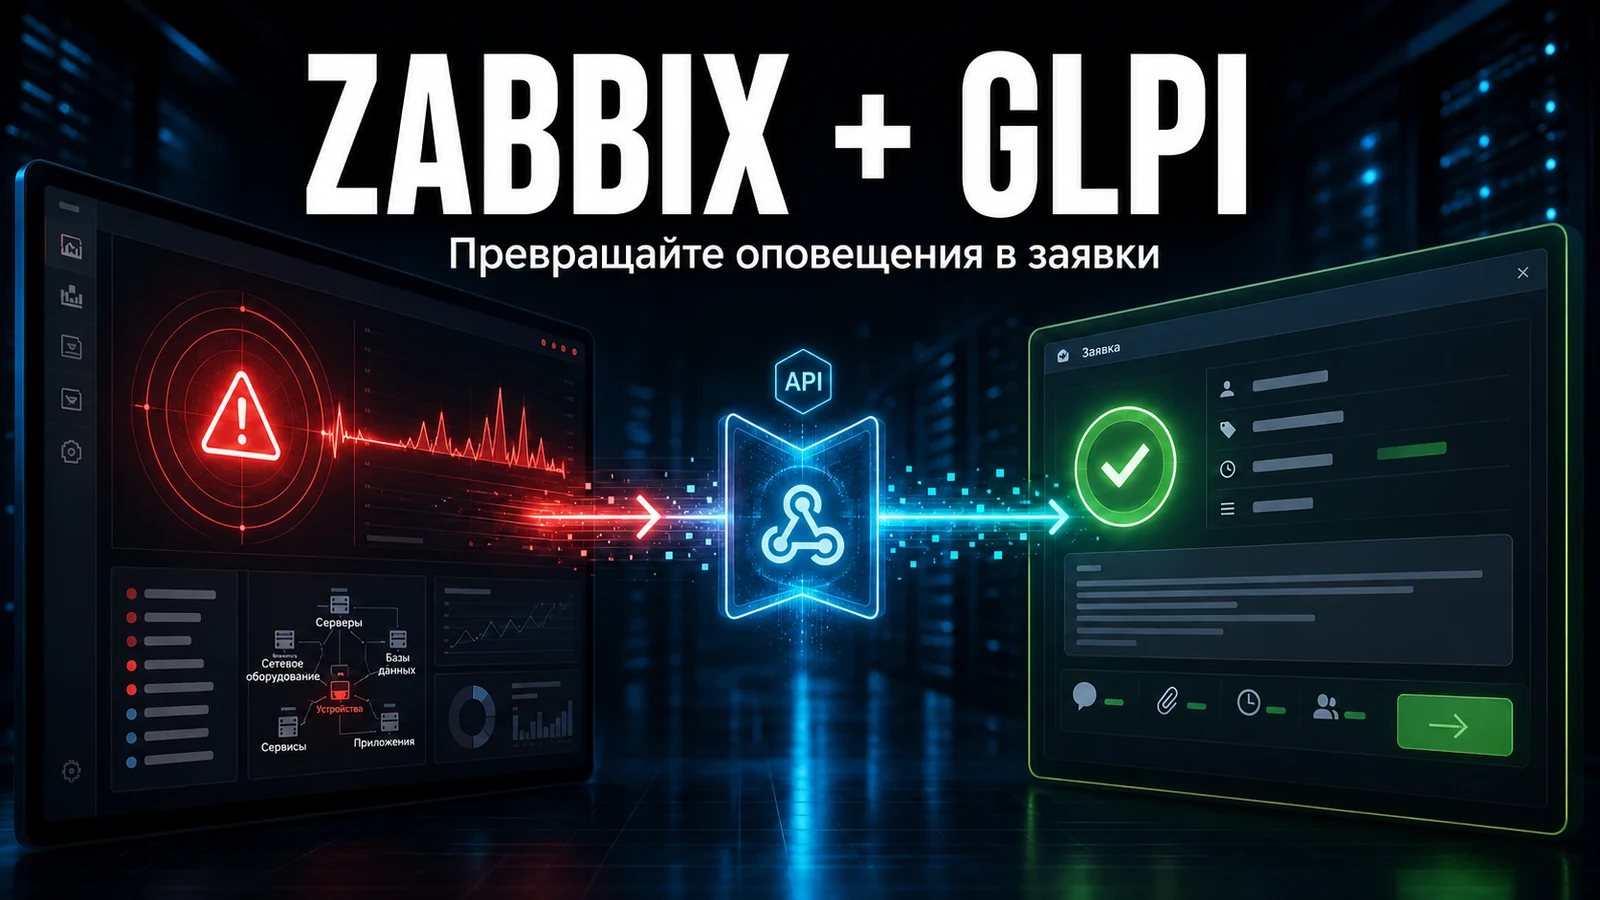
Zabbix становится проактивным мониторингом, когда оповещение перестаёт быть письмом, которое никто не читает, и становится заявкой в GLPI с ответственным, приоритетом и контекстом. В NexTool Zabbix не работает изолированно: он стоит рядом с GLPI, который мы уже сопровождаем для клиента, и каждый значимый триггер с самого начала связан с процессом реагирования. В этой статье показано, как мы внедряем и сопровождаем эту связку — от архитектуры до реального триггера и интеграции с модулем Automations NexTool.
Архитектура: Zabbix рядом с GLPI, а не в конкуренции с ним
Классическая ошибка — рассматривать Zabbix и GLPI как отдельные миры: Zabbix кричит, кто-то это видит и создаёт заявку вручную. Это добавляет минуты (или часы) между обнаружением и действием и зависит от того, смотрит ли человек на панель. В нашем внедрении Zabbix Server работает в контейнере рядом со стеком клиента, а на отслеживаемых хостах установлен Zabbix Agent 2. Точка интеграции — media type типа webhook в Zabbix, который отправляет POST на stateless-эндпоинт модуля Automations NexTool, — и уже Automations создаёт заявку в GLPI с аутентификацией HMAC SHA-256 для каждого процесса.
Такое разделение ролей важно: Zabbix решает, что является сигналом, достойным действия (триггер); Automations решает, как это превращается в работу службы поддержки (категория, организация, срочность, специалист). Заменить одно, не трогая другое, становится тривиальной задачей.
Триггеры, которые имеют значение: временное окно и восстановление, а не единичный пик
В сопровождении причина номер один того, что «все глушат Zabbix», — флаппинг: двухсекундный пик загрузки CPU поднимает и снимает оповещение десятки раз в час. Защита двойная — оценивать по временному окну и использовать отдельное выражение восстановления (гистерезис), чтобы проблема закрывалась, только когда ситуация действительно стабилизировалась. Триггер заполнения диска, написанный так, чтобы предсказать сбой до того, как он произойдёт, выглядит так:
# Trigger: root filesystem will fill up within the next 24h (prediction, not reaction)
# name: "Disk {HOST.NAME}: predicted saturation of / within 24h"
timeleft(/Linux by Zabbix agent/vfs.fs.size[/,pfree],1h,0)<24h
  and
last(/Linux by Zabbix agent/vfs.fs.size[/,pused])>80

# Trigger with hysteresis (recovery different from problem) to avoid CPU flapping
# Problem  expression:
avg(/Linux by Zabbix agent/system.cpu.util,5m)>90
# Recovery expression (only clears when it really drops):
avg(/Linux by Zabbix agent/system.cpu.util,5m)<70
Функция timeleft() — сердце «проактивности»: она проецирует по тренду, сколько времени осталось до заполнения диска, и оповещает, пока ещё можно действовать, а не когда сервис уже упал. Типичная ошибка здесь — использовать last() со значением 95% заполнения и называть это проактивным; это не так, это реактивный мониторинг с более мягким порогом.
Шаблоны и макросы: единообразие между хостами
Мы стандартизируем серверы, сеть и приложения через привязанные шаблоны, а пороги выносим в макросы ({$CPU.UTIL.CRIT}, {$VFS.FS.PUSED.MAX.CRIT}). Так хост, который обоснованно работает с высокой нагрузкой (например, СУБД), получает переопределение макроса на самом хосте, без дублирования триггера и без нарушения стандарта для остальных 200 хостов. Это ускоряет подключение новых хостов и предотвращает тихое расхождение, которое портит любой зрелый мониторинг.
Интеграция с GLPI: webhook, который превращается в заявку
Media type типа webhook в Zabbix — это скрипт на JavaScript, который собирает payload и выполняет POST. То, что мы отправляем в Automations, содержит достаточно данных, чтобы заявка создавалась с контекстом, — серьёзность, хост, элемент данных, значение и {EVENT.ID}, который мы используем как ключ идемпотентности, чтобы не открывать две заявки по одному событию:
// Zabbix media type (webhook) -> Automacoes NexTool -> GLPI
var req = new HttpRequest();
req.addHeader('Content-Type: application/json');
req.addHeader('X-Signature: ' + hmacSha256(params.payload, params.secret));

var payload = JSON.stringify({
  evento_id:  '{EVENT.ID}',        // chave de idempotencia
  severidade: '{EVENT.SEVERITY}',  // mapeada para urgencia GLPI
  host:       '{HOST.NAME}',
  gatilho:    '{TRIGGER.NAME}',
  valor:      '{ITEM.VALUE}',
  status:     '{EVENT.VALUE}'      // 1=problema, 0=recuperado
});

var resp = req.post('https://glpi.cliente.com/automacoes/hook/zabbix', payload);
return JSON.stringify({ tags: [{ tag: '__glpi_ticket', value: resp }] });
На стороне GLPI процесс Automations сопоставляет серьёзность Zabbix со срочностью заявки, выбирает нужные категорию и организацию и назначает ответственную группу специалистов. Когда событие восстанавливается (status: 0), тот же процесс может добавить комментарий «решено автоматически» или закрыть заявку — замыкая цикл обнаружение -> действие -> решение без ручного вмешательства.
Реактивный и проактивный мониторинг на практике
| Измерение | Реактивный мониторинг | Проактивный мониторинг |
|---|---|---|
| Триггер | Сервис уже упал (last() = 0) | Тренд прогнозирует сбой (timeleft(), forecast()) |
| Окно | Мгновенное значение, единичный пик | Среднее/тренд по окну (5m, 1h) |
| Ложные срабатывания | Много (флаппинг) | Мало (гистерезис/восстановление) |
| Результат в GLPI | Заявка создаётся поздно, без контекста | Заявка с ответственным, срочностью и значением события |
| Влияние на команду | Усталость от оповещений, панель игнорируется | Мало оповещений, и все требуют действий |
Типичные ошибки, которые мы исправляем в сопровождении
- Нет выражения восстановления: проблема и восстановление используют одно и то же условие, оповещение мигает. Всегда задавайте гистерезис для волатильных метрик (CPU, задержка).
- Серьёзность без сопоставления: всё приходит в GLPI как «средняя». Сопоставьте
Disaster/Highс высокой срочностью, аInformationоставьте только на панели, без создания заявок. - Нет идемпотентности: повторные попытки webhook создают дублирующиеся заявки. Использование
{EVENT.ID}в качестве ключа решает проблему. - Оповещение без ответственного: триггер, не указывающий группу/специалиста, — это шум. Каждому оповещению, требующему действий, нужен маршрут назначения в процессе Automations.
Если у вас уже есть GLPI и вы хотите, чтобы Zabbix перестал порождать игнорируемые письма и начал создавать заявки с ответственным и контекстом, — именно эту работу по внедрению и сопровождению выполняет NexTool, от шаблона до процесса интеграции. Свяжитесь с нами по поводу поддержки и сопровождения вашей среды GLPI + мониторинг.
Проверено командой NexTool Solutions.